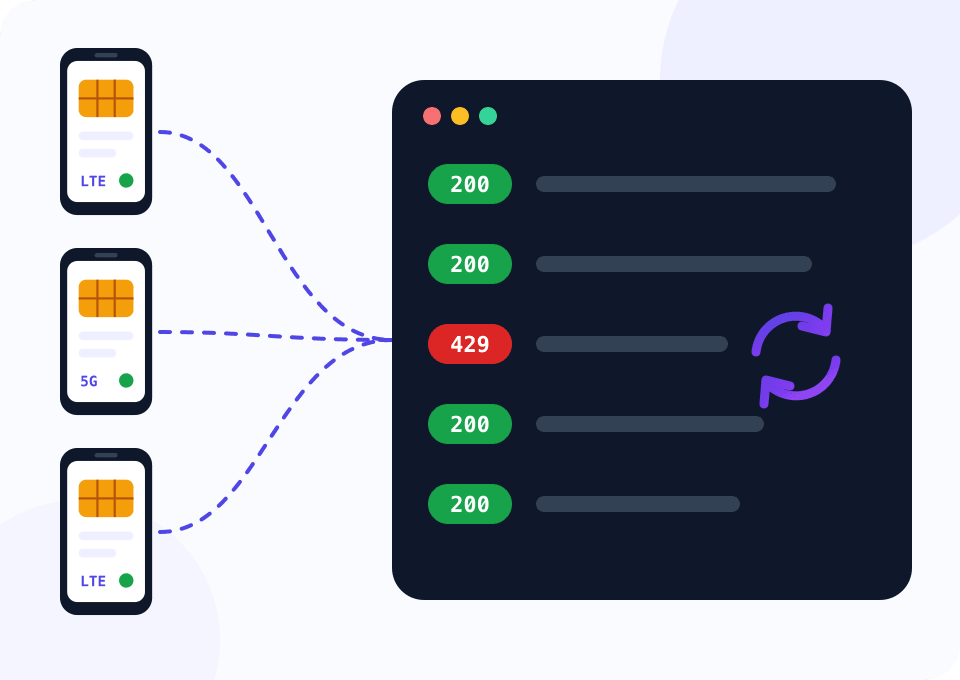
爬虫为什么会遇到封锁
网站会统计每个地址的请求数。数据中心的网段早已被列入名单,受保护的网站往往在第一次请求时就对这类 IP 弹出验证码。即使是干净的地址,几百次访问后也会收到 429 或验证页面。
移动地址的封锁成本更高:它背后是运营商的普通用户。即使达到了限制,也可以通过链接更换 IP:手机进入飞行模式几秒钟,再以运营商分配的新地址重新上线。
大批量采集需要由几部手机组成的代理池。下面的脚本把页面 URL 分发给各个代理,只在被封锁的那个代理上更换 IP,其余代理继续工作。
五部手机的代理池,用一个月
计算器默认打开 Professional 套餐、五台设备和 30 天。对抓取来说,这个套餐的主要区别是速度:最高 100 Mbps,而 Beginner 为 5 Mbps。五台设备可享受批量折扣,“每台设备 / 月”一行显示单个代理的费用。
如何把代理池接入爬虫
无论是两部手机还是二十部,步骤都一样。
连接手机
在插有两三家运营商 SIM 卡的 Android 手机上安装 Mobihub,并在每部手机上创建 Professional 套餐的代理。
开启 Unique IP
更换地址时,手机会多次尝试,直到获得该代理此前未使用过的 IP;尝试次数在设置中指定。这样爬虫较少碰到网站最近封锁过的地址。
编写 proxies.csv
为每个代理从控制台复制连接地址和 IP 更换链接。文件有三列:name、proxy 和 rotate_url。
设定请求节奏
先在通过同一部手机的请求之间停顿两到三秒,如果封锁频繁再加长。频繁更换 IP 代替不了平稳的节奏。
运行脚本并查看汇总
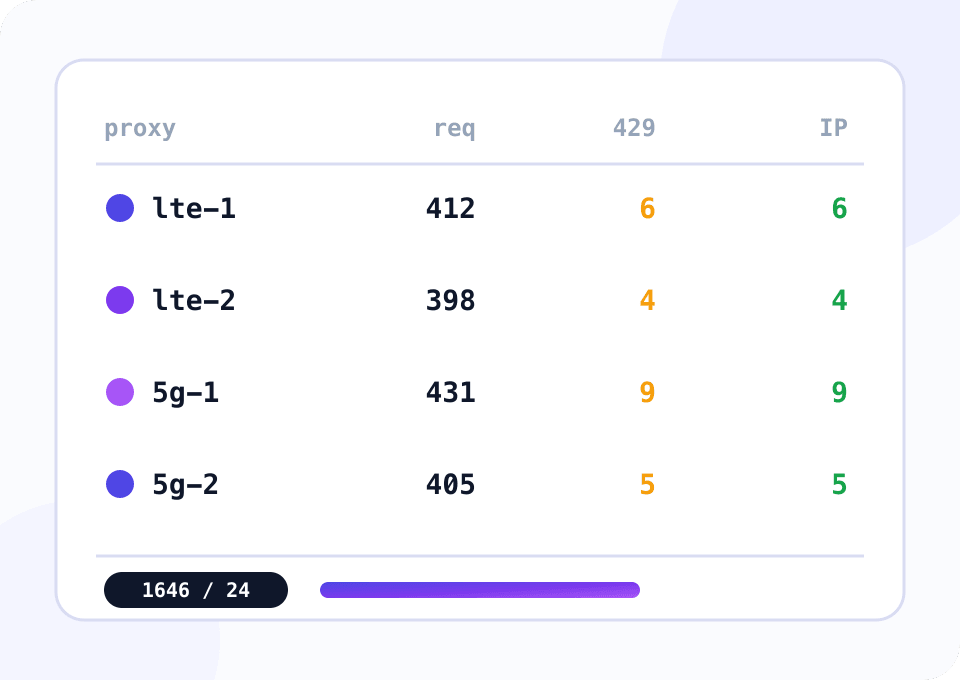
每次尝试都会写入 results.jsonl。脚本最后会输出每个代理的请求数、封锁次数和 IP 更换次数。
脚本:通过遇封锁即换 IP 的代理池进行抓取
脚本把 urls.txt 中的 URL 分发给 proxies.csv 中的代理,每部手机一个线程。403、429 或验证码页面都算作封锁:该 URL 回到队列,清除 cookies,并调用该代理的 IP 更换链接。脚本等待新地址后继续工作,其他手机照常运行。如果 IP 没能更换,这部手机会退出代理池,由其他手机接手它的 URL。页面代码中的 reCAPTCHA 脚本不算封锁:脚本查找的是用户能看到的验证提示文字。
import csv
import json
import queue
import random
import re
import threading
import time
from concurrent.futures import ThreadPoolExecutor
from datetime import datetime, timezone

import requests

PROXIES_FILE = "proxies.csv"
URLS_FILE = "urls.txt"
RESULTS_FILE = "results.jsonl"
IP_ECHO = "https://api.ipify.org"
BLOCK_CODES = {403, 429}
BLOCK_PHRASES = ("verify you are human", "are you a robot", "unusual traffic", "access denied", "не робот")
PAUSE = (1.5, 3.5)
MAX_ATTEMPTS = 3
ROTATE_TIMEOUT = 90
REFUSED_WAIT = 60
ROTATE_TRIES = 3
HEADERS = {
    "User-Agent": "Mozilla/5.0 (Linux; Android 13; Pixel 7) AppleWebKit/537.36 "
    "(KHTML, like Gecko) Chrome/126.0 Mobile Safari/537.36",
}

write_lock = threading.Lock()


def exit_ip(session):
    try:
        return session.get(IP_ECHO, timeout=15).text.strip()
    except requests.RequestException:
        return None


def request_change(proxy):
    for attempt in range(ROTATE_TRIES):
        if attempt:
            time.sleep(REFUSED_WAIT)
        try:
            answer = requests.get(proxy["rotate_url"], timeout=15).json()
        except (requests.RequestException, ValueError):
            answer = {}
        if answer.get("result") == "Success":
            return True
    return False


def rotate(proxy, session):
    previous = exit_ip(session)
    if not request_change(proxy):
        return False
    deadline = time.time() + ROTATE_TIMEOUT
    while time.time() < deadline:
        time.sleep(5)
        current = exit_ip(session)
        if current and current != previous:
            return True
    return False


def visible_text(html):
    html = re.sub(r"(?is)<(script|style)\b.*?</\1>", " ", html[:20000])
    return re.sub(r"<[^>]+>", " ", html).lower()


def blocked(response):
    if response.status_code in BLOCK_CODES:
        return True
    text = visible_text(response.text)
    return any(phrase in text for phrase in BLOCK_PHRASES)


def handle(session, proxy, stats, tasks, url, attempt):
    record = {
        "at": datetime.now(timezone.utc).isoformat(timespec="seconds"),
        "url": url,
        "proxy": proxy["name"],
        "attempt": attempt,
    }
    retry = False
    usable = True
    try:
        response = session.get(url, timeout=30)
        stats["requests"] += 1
        record["status"] = response.status_code
        if blocked(response):
            stats["blocks"] += 1
            record["state"] = "blocked"
            retry = True
            session.cookies.clear()
            if rotate(proxy, session):
                stats["rotations"] += 1
            else:
                usable = False
        else:
            record["state"] = "ok"
            record["bytes"] = len(response.content)
    except requests.RequestException as error:
        record["state"] = f"error: {type(error).__name__}"
        retry = True
    if retry and attempt < MAX_ATTEMPTS:
        tasks.put((url, attempt + 1))
    return record, usable


def worker(proxy, tasks, results):
    session = requests.Session()
    session.proxies = {"http": proxy["proxy"], "https": proxy["proxy"]}
    session.headers.update(HEADERS)
    stats = {"name": proxy["name"], "requests": 0, "blocks": 0, "rotations": 0}
    while True:
        try:
            url, attempt = tasks.get(timeout=1)
        except queue.Empty:
            if tasks.unfinished_tasks == 0:
                return stats
            continue
        try:
            record, usable = handle(session, proxy, stats, tasks, url, attempt)
        finally:
            tasks.task_done()
        with write_lock:
            results.write(json.dumps(record, ensure_ascii=False) + "\n")
            results.flush()
        if not usable:
            print(f"{proxy['name']}: IP did not change, the proxy leaves the pool")
            return stats
        time.sleep(random.uniform(*PAUSE))


def main():
    with open(PROXIES_FILE, newline="") as f:
        pool = list(csv.DictReader(f))
    tasks = queue.Queue()
    with open(URLS_FILE) as f:
        for line in f:
            if line.strip():
                tasks.put((line.strip(), 1))

    with open(RESULTS_FILE, "a") as results, ThreadPoolExecutor(len(pool)) as executor:
        summary = list(executor.map(lambda proxy: worker(proxy, tasks, results), pool))

    print(f"{'proxy':<12}{'requests':>10}{'blocks':>8}{'rotations':>11}")
    for row in summary:
        print(f"{row['name']:<12}{row['requests']:>10}{row['blocks']:>8}{row['rotations']:>11}")
    if tasks.qsize():
        print(f"{tasks.qsize()} URLs left: every proxy in the pool is blocked")


if __name__ == "__main__":
    main()
IP 更换链接返回代码 200,并在响应正文中写明 Success 或 Failure。例如请求更换过于频繁时会返回 Failure:脚本会等待一分钟,再重试两次。手机处于飞行模式时其代理不可用,因此一次更换需要几十秒。
网页抓取该选哪个套餐
对抓取来说,两个套餐的区别在于速度和流量节省。
测试网站、调试脚本
最高 5 Mbps 足以观察网站对移动地址的反应,并用一小批页面调试爬虫。
- 每台设备 $4,30 天
- 速度最高 5 Mbps
- 通过链接和定时器更换 IP
- 登录验证或 IP 白名单访问
持续的数据采集
每台设备最高 100 Mbps,支持 Unique IP 和 SmartRelay:手机通过移动网络下载页面,再通过 Wi‑Fi 发送到服务器,SIM 卡的流量消耗减少约一半。
- 每台设备 $7,30 天
- 速度最高 100 Mbps
- 更换后获得 Unique IP
- SmartRelay 和批量折扣
如何采集数据而不把地址用废
只采集公开数据
只采集网站无需登录即可显示的内容,遵守网站条款和个人数据相关法律。更换地址并不能让被禁止的采集变得合法。
节奏比轮换更重要
网站先注意到的是请求节奏,而不是地址。请求之间随机停顿,比频繁更换 IP 更能减少封锁。
Cookies 属于地址
如果网站在首次访问时设置了 cookies,请把它们保留在同一个代理的会话中,并在每次更换 IP 时清除。为一个地址签发的 cookies 从另一个地址发来,会显得可疑。
代理池里放几家运营商
两三家运营商的 SIM 卡提供来自不同网段的地址,即使一家运营商出问题,代理池也不会整体停摆。
只下载需要的数据
带图片和脚本的页面有好几 MB。只请求网站的 HTML 或 API,不加载多余资源;在 Professional 套餐上还可以为连接设置流量上限。
