Proxy di động cho web scraping
Scraper cần một địa chỉ mà trang web không cắt ngay trong một trăm request đầu tiên. Hàng trăm thuê bao dùng chung IP bên ngoài của nhà mạng, nên chặn nó là quá đắt đối với trang web. Trong Mobihub, proxy chạy trên điện thoại của chính bạn: IP đổi bằng một liên kết từ script hoặc theo hẹn giờ, còn HTTP và SOCKS5 dùng chung một cổng.
- từ 3 phút
- chu kỳ đổi IP theo hẹn giờ
- 1 liên kết
- đổi IP từ script của bạn
- HTTP + SOCKS5
- trên một cổng
- 100 Mbps
- tốc độ trên gói Professional
Vì sao scraper bị chặn
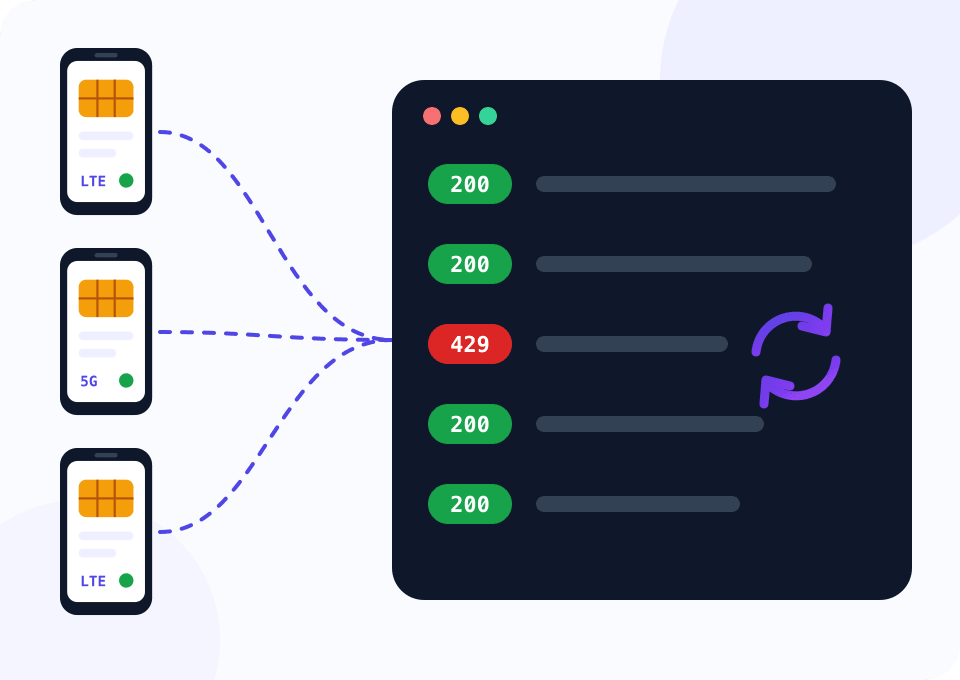
Trang web đếm request từ mỗi địa chỉ. Các dải IP data center đã nằm trong danh sách từ lâu, và trang web có bảo vệ thường đón IP như vậy bằng captcha ngay từ request đầu tiên. Ngay cả địa chỉ sạch cũng nhận mã 429 hoặc trang kiểm tra sau vài trăm lượt truy cập.
Địa chỉ di động khó chặn hơn: đằng sau nó là các thuê bao bình thường của nhà mạng. Nếu vẫn chạm giới hạn, IP được đổi bằng liên kết: điện thoại bật chế độ máy bay vài giây rồi trở lại mạng với địa chỉ mới từ nhà mạng.
Khối lượng lớn cần một nhóm vài điện thoại. Script bên dưới chia URL trang cho các proxy và chỉ đổi IP trên proxy bị chặn, trong khi các proxy còn lại vẫn tiếp tục làm việc.
Nhóm năm điện thoại trong một tháng
Widget mở sẵn gói Professional, năm thiết bị và 30 ngày. Với scraping, khác biệt chính của gói này là tốc độ: tới 100 Mbps thay vì 5 Mbps trên Beginner. Năm thiết bị được giảm giá theo số lượng, và dòng “Mỗi thiết bị / tháng” cho thấy giá của một proxy.
Cách gắn nhóm proxy vào scraper
Các bước giống nhau dù bạn có hai hay hai mươi điện thoại.
Kết nối các điện thoại
Cài Mobihub lên điện thoại Android có SIM của hai hoặc ba nhà mạng và tạo trên mỗi máy một proxy gói Professional.
Bật IP duy nhất
Khi đổi địa chỉ, điện thoại thử vài lần cho đến khi nhận được IP mà proxy này chưa từng có; số lần thử đặt trong phần cài đặt. Scraper sẽ ít khi rơi vào địa chỉ mà trang web vừa chặn.
Tạo file proxies.csv
Với mỗi proxy, lấy địa chỉ kết nối và liên kết đổi IP trong bảng điều khiển. File có ba cột: name, proxy và rotate_url.
Đặt nhịp độ
Bắt đầu với khoảng nghỉ hai đến ba giây giữa các request qua một điện thoại và tăng lên nếu hay bị chặn. Đổi IP thường xuyên không thay thế được nhịp độ vừa phải.
Chạy script và đọc tổng kết
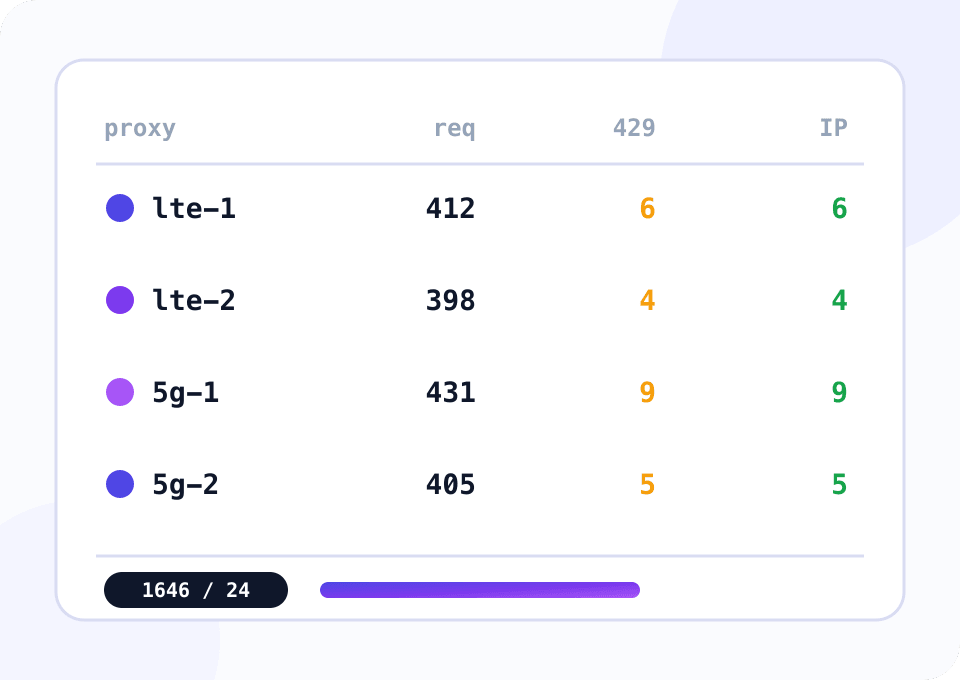
Mỗi lần thử được ghi vào results.jsonl. Cuối cùng script in ra số request, số lần bị chặn và số lần đổi IP của từng proxy.
Script: scraping qua nhóm proxy tự đổi IP khi bị chặn
Script chia URL từ urls.txt cho các proxy trong proxies.csv, mỗi điện thoại một luồng. Mã 403, 429 hoặc trang captcha được tính là bị chặn: URL quay lại hàng đợi, cookie bị xóa và liên kết đổi IP của proxy được gọi. Script chờ địa chỉ mới rồi làm tiếp, trong khi các điện thoại khác vẫn chạy. Nếu không đổi được IP, điện thoại rời khỏi nhóm và các máy còn lại nhận URL của nó. Script reCAPTCHA trong mã trang không bị tính là chặn: script tìm dòng chữ kiểm tra mà người dùng nhìn thấy.
import csv
import json
import queue
import random
import re
import threading
import time
from concurrent.futures import ThreadPoolExecutor
from datetime import datetime, timezone

import requests

PROXIES_FILE = "proxies.csv"
URLS_FILE = "urls.txt"
RESULTS_FILE = "results.jsonl"
IP_ECHO = "https://api.ipify.org"
BLOCK_CODES = {403, 429}
BLOCK_PHRASES = ("verify you are human", "are you a robot", "unusual traffic", "access denied", "не робот")
PAUSE = (1.5, 3.5)
MAX_ATTEMPTS = 3
ROTATE_TIMEOUT = 90
REFUSED_WAIT = 60
ROTATE_TRIES = 3
HEADERS = {
    "User-Agent": "Mozilla/5.0 (Linux; Android 13; Pixel 7) AppleWebKit/537.36 "
    "(KHTML, like Gecko) Chrome/126.0 Mobile Safari/537.36",
}

write_lock = threading.Lock()


def exit_ip(session):
    try:
        return session.get(IP_ECHO, timeout=15).text.strip()
    except requests.RequestException:
        return None


def request_change(proxy):
    for attempt in range(ROTATE_TRIES):
        if attempt:
            time.sleep(REFUSED_WAIT)
        try:
            answer = requests.get(proxy["rotate_url"], timeout=15).json()
        except (requests.RequestException, ValueError):
            answer = {}
        if answer.get("result") == "Success":
            return True
    return False


def rotate(proxy, session):
    previous = exit_ip(session)
    if not request_change(proxy):
        return False
    deadline = time.time() + ROTATE_TIMEOUT
    while time.time() < deadline:
        time.sleep(5)
        current = exit_ip(session)
        if current and current != previous:
            return True
    return False


def visible_text(html):
    html = re.sub(r"(?is)<(script|style)\b.*?</\1>", " ", html[:20000])
    return re.sub(r"<[^>]+>", " ", html).lower()


def blocked(response):
    if response.status_code in BLOCK_CODES:
        return True
    text = visible_text(response.text)
    return any(phrase in text for phrase in BLOCK_PHRASES)


def handle(session, proxy, stats, tasks, url, attempt):
    record = {
        "at": datetime.now(timezone.utc).isoformat(timespec="seconds"),
        "url": url,
        "proxy": proxy["name"],
        "attempt": attempt,
    }
    retry = False
    usable = True
    try:
        response = session.get(url, timeout=30)
        stats["requests"] += 1
        record["status"] = response.status_code
        if blocked(response):
            stats["blocks"] += 1
            record["state"] = "blocked"
            retry = True
            session.cookies.clear()
            if rotate(proxy, session):
                stats["rotations"] += 1
            else:
                usable = False
        else:
            record["state"] = "ok"
            record["bytes"] = len(response.content)
    except requests.RequestException as error:
        record["state"] = f"error: {type(error).__name__}"
        retry = True
    if retry and attempt < MAX_ATTEMPTS:
        tasks.put((url, attempt + 1))
    return record, usable


def worker(proxy, tasks, results):
    session = requests.Session()
    session.proxies = {"http": proxy["proxy"], "https": proxy["proxy"]}
    session.headers.update(HEADERS)
    stats = {"name": proxy["name"], "requests": 0, "blocks": 0, "rotations": 0}
    while True:
        try:
            url, attempt = tasks.get(timeout=1)
        except queue.Empty:
            if tasks.unfinished_tasks == 0:
                return stats
            continue
        try:
            record, usable = handle(session, proxy, stats, tasks, url, attempt)
        finally:
            tasks.task_done()
        with write_lock:
            results.write(json.dumps(record, ensure_ascii=False) + "\n")
            results.flush()
        if not usable:
            print(f"{proxy['name']}: IP did not change, the proxy leaves the pool")
            return stats
        time.sleep(random.uniform(*PAUSE))


def main():
    with open(PROXIES_FILE, newline="") as f:
        pool = list(csv.DictReader(f))
    tasks = queue.Queue()
    with open(URLS_FILE) as f:
        for line in f:
            if line.strip():
                tasks.put((line.strip(), 1))

    with open(RESULTS_FILE, "a") as results, ThreadPoolExecutor(len(pool)) as executor:
        summary = list(executor.map(lambda proxy: worker(proxy, tasks, results), pool))

    print(f"{'proxy':<12}{'requests':>10}{'blocks':>8}{'rotations':>11}")
    for row in summary:
        print(f"{row['name']:<12}{row['requests']:>10}{row['blocks']:>8}{row['rotations']:>11}")
    if tasks.qsize():
        print(f"{tasks.qsize()} URLs left: every proxy in the pool is blocked")


if __name__ == "__main__":
    main()
Liên kết đổi IP trả về mã 200 và ghi Success hoặc Failure trong nội dung. Failure xảy ra, chẳng hạn, khi yêu cầu đổi quá thường xuyên: script chờ một phút và thử thêm hai lần. Trong lúc điện thoại ở chế độ máy bay, proxy của nó không truy cập được, nên một lần đổi mất vài chục giây.
Chọn gói nào cho scraping
Với scraping, khác biệt giữa các gói nằm ở tốc độ và khả năng tiết kiệm traffic.
Thử trang web và gỡ lỗi script
Tốc độ tới 5 Mbps đủ để xem trang web phản ứng thế nào với địa chỉ di động và gỡ lỗi scraper trên một danh sách trang ngắn.
- $4 mỗi thiết bị cho 30 ngày
- Tốc độ tới 5 Mbps
- Đổi IP bằng liên kết và theo hẹn giờ
- Truy cập bằng tên đăng nhập hoặc danh sách IP cho phép
Thu thập dữ liệu thường xuyên
Tới 100 Mbps mỗi thiết bị, IP duy nhất và SmartRelay: điện thoại tải trang qua mạng di động và gửi về máy chủ qua Wi‑Fi, nên dung lượng dữ liệu của SIM hao chậm khoảng một nửa.
- $7 mỗi thiết bị cho 30 ngày
- Tốc độ tới 100 Mbps
- IP duy nhất sau khi đổi
- SmartRelay và giảm giá theo số lượng
Cách thu thập dữ liệu mà không làm cháy địa chỉ
Chỉ dữ liệu công khai
Thu thập những gì trang web hiển thị mà không cần đăng nhập, tuân thủ điều khoản của trang và luật về dữ liệu cá nhân. Đổi địa chỉ không biến việc thu thập bị cấm thành hợp pháp.
Nhịp độ quan trọng hơn xoay IP
Trang web để ý nhịp độ trước cả địa chỉ. Khoảng nghỉ ngẫu nhiên giữa các request giảm chặn hiệu quả hơn việc đổi IP thường xuyên.
Cookie gắn với địa chỉ
Nếu trang web đặt cookie ở lần truy cập đầu, hãy giữ chúng trong phiên của một proxy và xóa đi mỗi khi đổi IP. Cookie cấp cho một địa chỉ mà lại đến từ địa chỉ khác trông rất đáng ngờ.
Nhiều nhà mạng trong nhóm
SIM của hai hoặc ba nhà mạng cho địa chỉ từ các dải mạng khác nhau, và nhóm sẽ không dừng hẳn nếu một nhà mạng gặp sự cố.
Chỉ tải những byte cần thiết
Một trang có ảnh và script nặng tới vài megabyte. Hãy chỉ lấy HTML hoặc API của trang mà không kèm tài nguyên thừa, và trên gói Professional đặt giới hạn traffic cho kết nối.
Câu hỏi thường gặp
Có thể đổi IP bằng liên kết thường xuyên đến mức nào?
Nên chạy bao nhiêu luồng scraper qua một điện thoại?
Proxy có dùng được với Selenium và Playwright không?
Có thể scraping các trang chỉ mở được từ một quốc gia không?
Vì sao trang web vẫn chặn sau khi đổi IP?
Proxy di động tốt hơn proxy máy chủ cho scraping ở điểm nào?
Proxy di động cho các nhu cầu khác
Thử trang web của bạn trên IP di động
Bộ phận hỗ trợ tặng khách hàng mới 24 giờ truy cập miễn phí. Kết nối điện thoại, chạy script trên một danh sách trang ngắn và xem còn lại bao nhiêu lần bị chặn.
