Proxies móveis para web scraping
Um scraper precisa de um endereço que o site não corte nas primeiras cem requisições. Centenas de assinantes dividem o IP externo de uma operadora, então bloqueá-lo sai caro demais para o site. No Mobihub, os proxies rodam nos seus próprios celulares: o IP muda por um link no seu script ou por timer, e HTTP e SOCKS5 usam a mesma porta.
- a partir de 3 min
- intervalo da troca de IP por timer
- 1 link
- troca de IP pelo seu script
- HTTP + SOCKS5
- na mesma porta
- 100 Mbps
- de velocidade no plano Professional
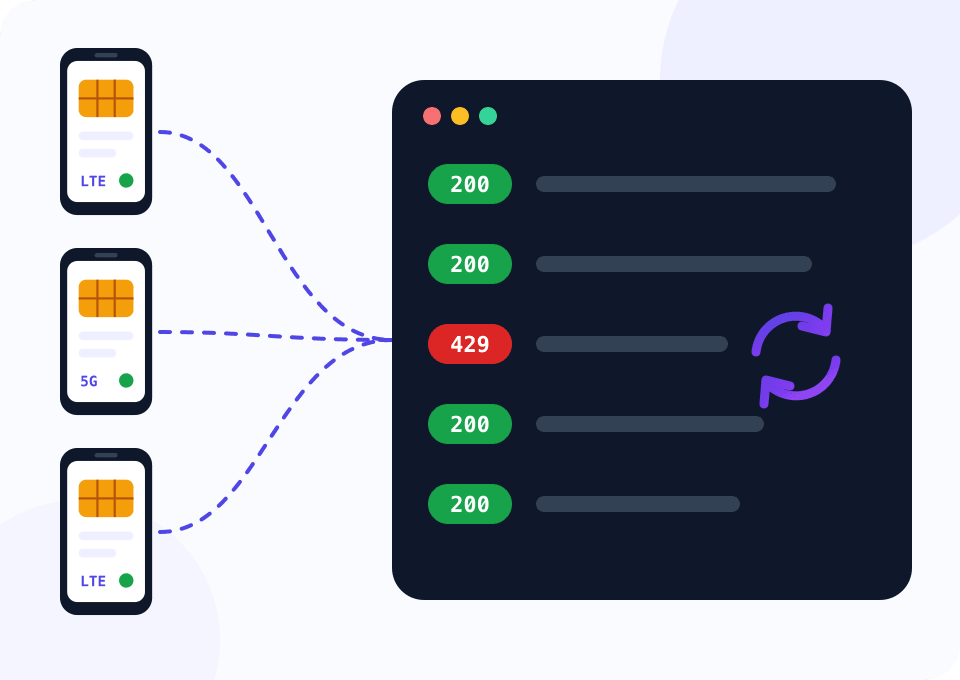
Por que os scrapers esbarram em bloqueios
Os sites contam as requisições de cada endereço. As sub-redes de data centers estão em listas há muito tempo, e um site protegido costuma receber esse IP com um captcha já na primeira requisição. Até um endereço limpo leva um 429 ou uma página de desafio depois de algumas centenas de acessos.
Um endereço móvel é mais caro de bloquear: atrás dele estão assinantes comuns da operadora. Se o limite for atingido mesmo assim, o IP muda por um link: o celular entra em modo avião por alguns segundos e volta à rede com um novo endereço da operadora.
Volume exige um pool de vários celulares. O script abaixo distribui as URLs das páginas entre os proxies e troca o IP só daquele que foi bloqueado, enquanto os outros continuam trabalhando.
Um pool de cinco celulares por um mês
O widget abre no Professional, com cinco dispositivos e 30 dias. Para scraping, a principal diferença do plano é a velocidade: até 100 Mbps em vez de 5 Mbps no Beginner. Cinco dispositivos dão desconto por volume, e a linha “Por dispositivo / mês” mostra o custo de um proxy.
Como ligar um pool a um scraper
Os passos são os mesmos para dois celulares e para vinte.
Conecte os celulares
Instale o Mobihub em celulares Android com chips de duas ou três operadoras e crie um proxy no plano Professional em cada um.
Ative o IP único
Ao trocar o endereço, o celular faz várias tentativas até conseguir um IP que esse proxy ainda não teve; o número de tentativas é definido nas configurações. O scraper cai menos vezes em um endereço que o site bloqueou há pouco.
Monte o proxies.csv
Para cada proxy, pegue no painel o endereço de conexão e o link de troca de IP. O arquivo tem três colunas: name, proxy e rotate_url.
Defina o ritmo
Comece com uma pausa de dois a três segundos entre requisições por um celular e aumente se os bloqueios forem frequentes. Trocas de IP frequentes não substituem um ritmo calmo.
Rode o script e leia o resumo
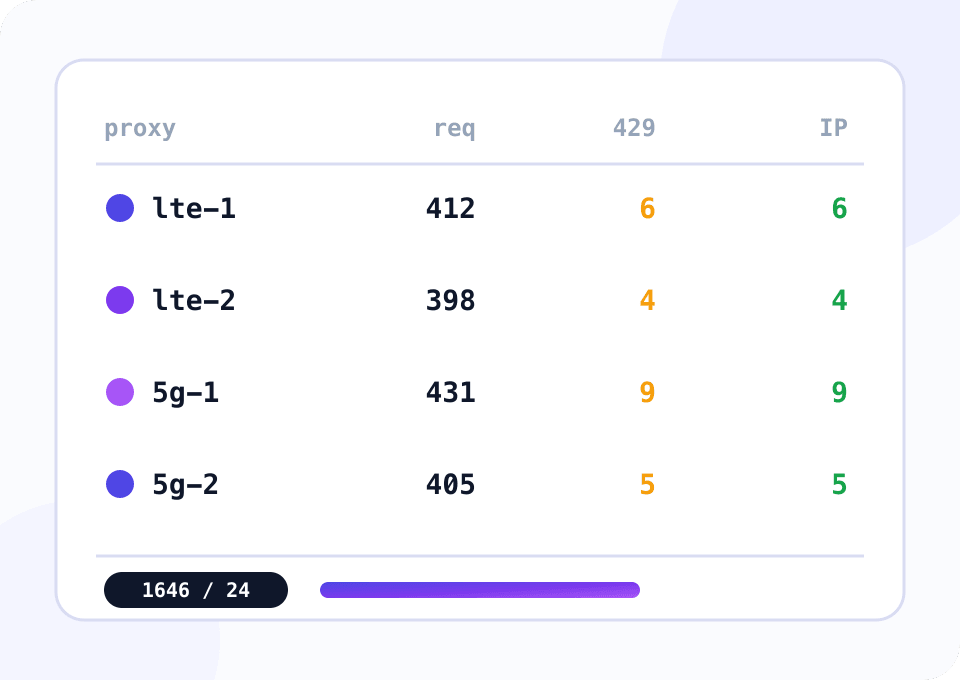
Cada tentativa vai para results.jsonl. No final, o script mostra o número de requisições, bloqueios e trocas de IP de cada proxy.
Script: scraping por um pool que troca o IP no bloqueio
O script distribui as URLs de urls.txt entre os proxies de proxies.csv, uma thread por celular. Um 403, um 429 ou uma página de captcha contam como bloqueio: a URL volta para a fila, os cookies são apagados e o link de troca de IP do proxy é chamado. O script espera o novo endereço e segue em frente enquanto os outros celulares continuam trabalhando. Se o IP não mudar, o celular sai do pool e os outros assumem as URLs dele. Um script do reCAPTCHA no código da página não conta como bloqueio: o script procura o texto do desafio que uma pessoa vê.
import csv
import json
import queue
import random
import re
import threading
import time
from concurrent.futures import ThreadPoolExecutor
from datetime import datetime, timezone

import requests

PROXIES_FILE = "proxies.csv"
URLS_FILE = "urls.txt"
RESULTS_FILE = "results.jsonl"
IP_ECHO = "https://api.ipify.org"
BLOCK_CODES = {403, 429}
BLOCK_PHRASES = ("verify you are human", "are you a robot", "unusual traffic", "access denied", "не робот")
PAUSE = (1.5, 3.5)
MAX_ATTEMPTS = 3
ROTATE_TIMEOUT = 90
REFUSED_WAIT = 60
ROTATE_TRIES = 3
HEADERS = {
    "User-Agent": "Mozilla/5.0 (Linux; Android 13; Pixel 7) AppleWebKit/537.36 "
    "(KHTML, like Gecko) Chrome/126.0 Mobile Safari/537.36",
}

write_lock = threading.Lock()


def exit_ip(session):
    try:
        return session.get(IP_ECHO, timeout=15).text.strip()
    except requests.RequestException:
        return None


def request_change(proxy):
    for attempt in range(ROTATE_TRIES):
        if attempt:
            time.sleep(REFUSED_WAIT)
        try:
            answer = requests.get(proxy["rotate_url"], timeout=15).json()
        except (requests.RequestException, ValueError):
            answer = {}
        if answer.get("result") == "Success":
            return True
    return False


def rotate(proxy, session):
    previous = exit_ip(session)
    if not request_change(proxy):
        return False
    deadline = time.time() + ROTATE_TIMEOUT
    while time.time() < deadline:
        time.sleep(5)
        current = exit_ip(session)
        if current and current != previous:
            return True
    return False


def visible_text(html):
    html = re.sub(r"(?is)<(script|style)\b.*?</\1>", " ", html[:20000])
    return re.sub(r"<[^>]+>", " ", html).lower()


def blocked(response):
    if response.status_code in BLOCK_CODES:
        return True
    text = visible_text(response.text)
    return any(phrase in text for phrase in BLOCK_PHRASES)


def handle(session, proxy, stats, tasks, url, attempt):
    record = {
        "at": datetime.now(timezone.utc).isoformat(timespec="seconds"),
        "url": url,
        "proxy": proxy["name"],
        "attempt": attempt,
    }
    retry = False
    usable = True
    try:
        response = session.get(url, timeout=30)
        stats["requests"] += 1
        record["status"] = response.status_code
        if blocked(response):
            stats["blocks"] += 1
            record["state"] = "blocked"
            retry = True
            session.cookies.clear()
            if rotate(proxy, session):
                stats["rotations"] += 1
            else:
                usable = False
        else:
            record["state"] = "ok"
            record["bytes"] = len(response.content)
    except requests.RequestException as error:
        record["state"] = f"error: {type(error).__name__}"
        retry = True
    if retry and attempt < MAX_ATTEMPTS:
        tasks.put((url, attempt + 1))
    return record, usable


def worker(proxy, tasks, results):
    session = requests.Session()
    session.proxies = {"http": proxy["proxy"], "https": proxy["proxy"]}
    session.headers.update(HEADERS)
    stats = {"name": proxy["name"], "requests": 0, "blocks": 0, "rotations": 0}
    while True:
        try:
            url, attempt = tasks.get(timeout=1)
        except queue.Empty:
            if tasks.unfinished_tasks == 0:
                return stats
            continue
        try:
            record, usable = handle(session, proxy, stats, tasks, url, attempt)
        finally:
            tasks.task_done()
        with write_lock:
            results.write(json.dumps(record, ensure_ascii=False) + "\n")
            results.flush()
        if not usable:
            print(f"{proxy['name']}: IP did not change, the proxy leaves the pool")
            return stats
        time.sleep(random.uniform(*PAUSE))


def main():
    with open(PROXIES_FILE, newline="") as f:
        pool = list(csv.DictReader(f))
    tasks = queue.Queue()
    with open(URLS_FILE) as f:
        for line in f:
            if line.strip():
                tasks.put((line.strip(), 1))

    with open(RESULTS_FILE, "a") as results, ThreadPoolExecutor(len(pool)) as executor:
        summary = list(executor.map(lambda proxy: worker(proxy, tasks, results), pool))

    print(f"{'proxy':<12}{'requests':>10}{'blocks':>8}{'rotations':>11}")
    for row in summary:
        print(f"{row['name']:<12}{row['requests']:>10}{row['blocks']:>8}{row['rotations']:>11}")
    if tasks.qsize():
        print(f"{tasks.qsize()} URLs left: every proxy in the pool is blocked")


if __name__ == "__main__":
    main()
O link de troca de IP responde com código 200 e escreve Success ou Failure no corpo. Failure aparece, por exemplo, quando as trocas são pedidas com frequência demais: o script espera um minuto e tenta mais duas vezes. Enquanto o celular está em modo avião, o proxy dele fica inacessível, então uma troca leva dezenas de segundos.
Qual plano escolher para scraping
Para scraping, a diferença entre os planos se resume à velocidade e à economia de tráfego.
Testar o site e depurar o script
Até 5 Mbps bastam para ver como o site reage a um endereço móvel e para depurar o scraper em uma lista curta de páginas.
- $4 por dispositivo por 30 dias
- Velocidade de até 5 Mbps
- Troca de IP por link e por timer
- Acesso por login ou lista de IPs permitidos
Coleta de dados contínua
Até 100 Mbps por dispositivo, IP único e SmartRelay: o celular baixa as páginas pela rede móvel e as envia ao servidor pelo Wi‑Fi, então a franquia do chip acaba cerca de duas vezes mais devagar.
- $7 por dispositivo por 30 dias
- Velocidade de até 100 Mbps
- IP único depois da troca
- SmartRelay e desconto por volume
Como coletar dados sem queimar endereços
Só dados públicos
Colete o que o site mostra sem login, siga os termos dele e as leis de dados pessoais. Trocar o endereço não torna legal uma coleta proibida.
Ritmo vale mais que rotação
O site percebe o ritmo antes do endereço. Uma pausa aleatória entre requisições reduz os bloqueios mais do que trocas de IP frequentes.
Cookies pertencem a um endereço
Se o site define cookies na primeira visita, mantenha-os na sessão de um proxy e apague-os a cada troca de IP. Cookies emitidos para um endereço chegando de outro parecem suspeitos.
Várias operadoras no pool
Chips de duas ou três operadoras dão endereços de sub-redes diferentes, e o pool não para por completo se uma operadora tiver problemas.
Só os bytes necessários
Uma página com imagens e scripts pesa megabytes. Peça o HTML ou a API do site sem recursos extras e, no Professional, defina um limite de tráfego na conexão.
Perguntas e respostas
Com que frequência dá para trocar o IP por link?
Quantas threads do scraper devem passar por um celular?
Os proxies funcionam com Selenium e Playwright?
Dá para fazer scraping de sites que só abrem em um país?
Por que o site continua bloqueando depois da troca de IP?
O que torna um proxy móvel melhor para scraping do que um de servidor?
Proxies móveis para outras tarefas
Teste seu site em um IP móvel
O suporte dá a novos clientes 24 horas de acesso grátis. Conecte um celular, rode o script em uma lista curta de páginas e veja quantos bloqueios sobram.
