พร็อกซี่มือถือสำหรับการดึงข้อมูลเว็บ
Scraper ต้องการที่อยู่ที่เว็บไซต์จะไม่ตัดทิ้งภายในร้อยคำขอแรก ผู้ใช้หลายร้อยคนใช้ IP ภายนอกเดียวกันของผู้ให้บริการเครือข่าย การบล็อก IP นั้นจึงสร้างความเสียหายให้เว็บไซต์มากเกินไป ใน Mobihub พร็อกซี่ทำงานบนโทรศัพท์ของคุณเอง: IP เปลี่ยนผ่านลิงก์จากสคริปต์ของคุณหรือตามตัวจับเวลา และ HTTP กับ SOCKS5 ใช้พอร์ตเดียวกัน
- ตั้งแต่ 3 นาที
- รอบการเปลี่ยน IP ตามตัวจับเวลา
- 1 ลิงก์
- เปลี่ยน IP จากสคริปต์ของคุณ
- HTTP + SOCKS5
- บนพอร์ตเดียว
- 100 Mbps
- ความเร็วบนแพ็กเกจ Professional
ทำไม scraper จึงโดนบล็อก
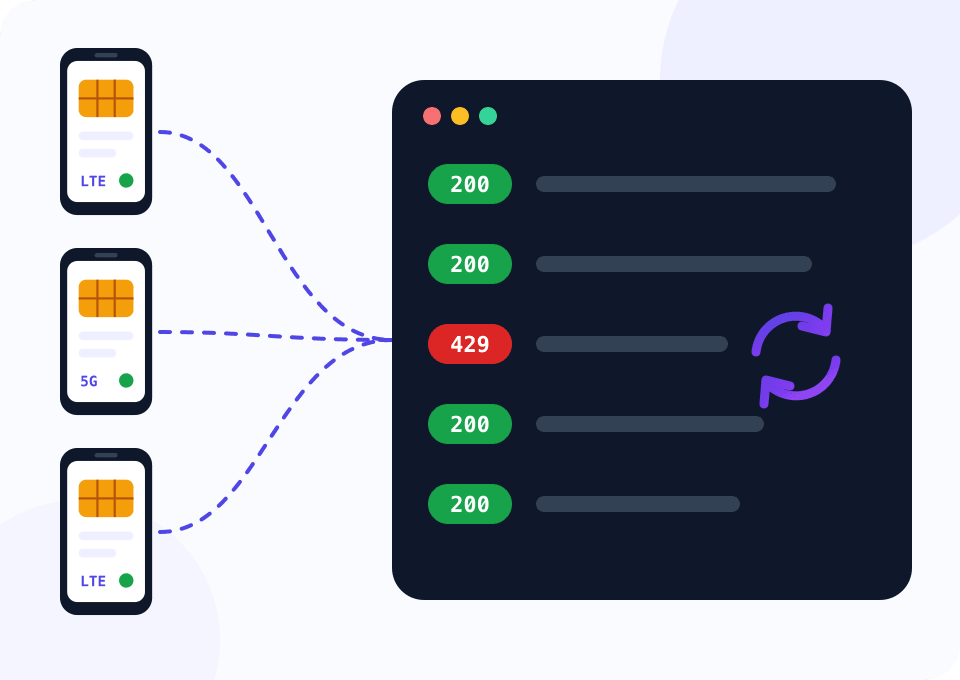
เว็บไซต์นับคำขอจากทุกที่อยู่ ซับเน็ตของดาต้าเซ็นเตอร์ถูกขึ้นบัญชีไว้นานแล้ว และเว็บไซต์ที่มีระบบป้องกันมักตอบ IP แบบนี้ด้วย captcha ตั้งแต่คำขอแรก แม้แต่ที่อยู่ที่สะอาดก็จะได้ 429 หรือหน้าตรวจสอบหลังเข้าไม่กี่ร้อยครั้ง
ที่อยู่มือถือบล็อกได้ยากกว่า เพราะเบื้องหลังคือผู้ใช้ทั่วไปของผู้ให้บริการเครือข่าย หากยังชนขีดจำกัด IP จะเปลี่ยนผ่านลิงก์: โทรศัพท์เข้าโหมดเครื่องบินไม่กี่วินาที แล้วกลับมาออนไลน์ด้วยที่อยู่ใหม่จากผู้ให้บริการเครือข่าย
งานปริมาณมากต้องใช้พูลโทรศัพท์หลายเครื่อง สคริปต์ด้านล่างกระจาย URL ของหน้าเว็บไปยังพร็อกซี่ต่าง ๆ และเปลี่ยน IP เฉพาะเครื่องที่โดนบล็อก ขณะที่เครื่องอื่นทำงานต่อ
พูลโทรศัพท์ห้าเครื่องสำหรับหนึ่งเดือน
วิดเจ็ตเปิดที่ Professional ห้าอุปกรณ์ และ 30 วัน สำหรับ scraping ความต่างหลักของแพ็กเกจคือความเร็ว: สูงสุด 100 Mbps แทน 5 Mbps บน Beginner ห้าอุปกรณ์ได้ส่วนลดตามจำนวน และแถว “ต่ออุปกรณ์ / เดือน” แสดงราคาของพร็อกซี่หนึ่งตัว
วิธีเชื่อมพูลพร็อกซี่เข้ากับ scraper
ขั้นตอนเหมือนกันทั้งสำหรับโทรศัพท์สองเครื่องและยี่สิบเครื่อง
เชื่อมต่อโทรศัพท์
ติดตั้ง Mobihub บนโทรศัพท์ Android ที่มีซิมการ์ดจากผู้ให้บริการเครือข่ายสองหรือสามราย และสร้างพร็อกซี่บนแพ็กเกจ Professional ในแต่ละเครื่อง
เปิด IP เฉพาะ
เมื่อเปลี่ยนที่อยู่ โทรศัพท์จะพยายามหลายครั้งจนได้ IP ที่พร็อกซี่นี้ยังไม่เคยใช้ จำนวนครั้งกำหนดได้ในการตั้งค่า Scraper จะได้ที่อยู่ที่เว็บไซต์เพิ่งบล็อกไปน้อยลง
สร้างไฟล์ proxies.csv
นำที่อยู่การเชื่อมต่อและลิงก์เปลี่ยน IP ของแต่ละพร็อกซี่จากแดชบอร์ด ไฟล์มีสามคอลัมน์: name, proxy และ rotate_url
กำหนดจังหวะ
เริ่มด้วยการพักสองถึงสามวินาทีระหว่างคำขอผ่านโทรศัพท์หนึ่งเครื่อง และเพิ่มขึ้นหากโดนบล็อกบ่อย การเปลี่ยน IP บ่อย ๆ ไม่ได้ทดแทนจังหวะที่ใจเย็น
รันสคริปต์และอ่านสรุปผล
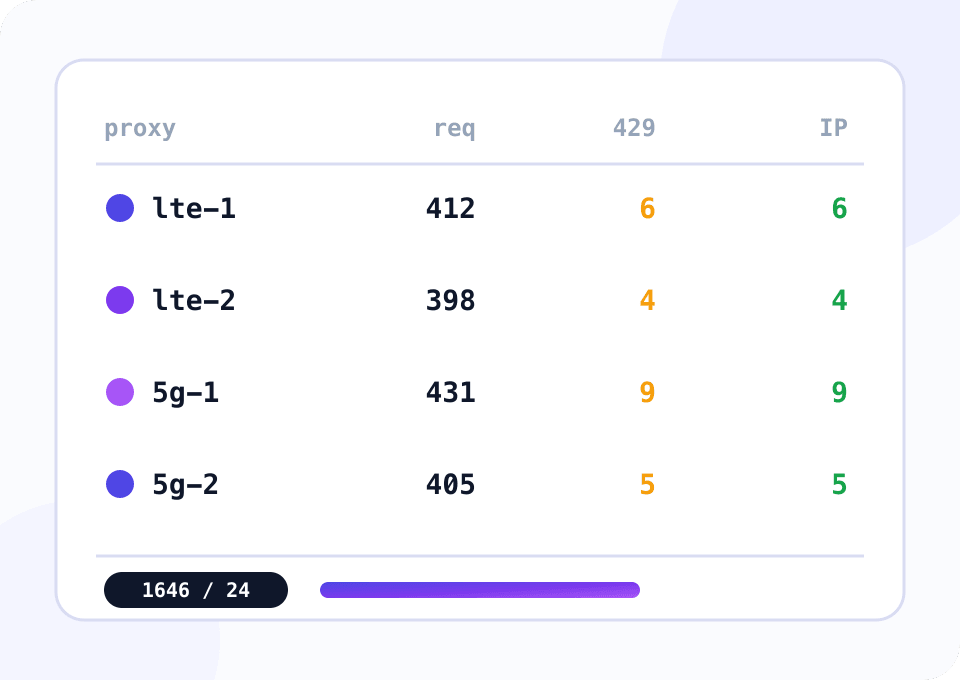
ทุกความพยายามถูกบันทึกลง results.jsonl เมื่อจบ สคริปต์จะแสดงจำนวนคำขอ การบล็อก และการเปลี่ยน IP ของแต่ละพร็อกซี่
สคริปต์: scraping ผ่านพูลที่เปลี่ยน IP เมื่อโดนบล็อก
สคริปต์กระจาย URL จาก urls.txt ไปยังพร็อกซี่ใน proxies.csv โดยใช้หนึ่งเธรดต่อโทรศัพท์หนึ่งเครื่อง คำตอบ 403, 429 หรือหน้า captcha ถือเป็นการบล็อก: URL กลับเข้าคิว คุกกี้ถูกล้าง และเรียกลิงก์เปลี่ยน IP ของพร็อกซี่นั้น สคริปต์รอที่อยู่ใหม่แล้วทำงานต่อ ขณะที่โทรศัพท์เครื่องอื่นยังทำงานอยู่ หากเปลี่ยน IP ไม่สำเร็จ โทรศัพท์เครื่องนั้นจะออกจากพูล และเครื่องอื่นรับ URL ไปแทน สคริปต์ reCAPTCHA ในโค้ดหน้าเว็บไม่นับเป็นการบล็อก: สคริปต์มองหาข้อความตรวจสอบที่คนเห็นบนหน้า
import csv
import json
import queue
import random
import re
import threading
import time
from concurrent.futures import ThreadPoolExecutor
from datetime import datetime, timezone

import requests

PROXIES_FILE = "proxies.csv"
URLS_FILE = "urls.txt"
RESULTS_FILE = "results.jsonl"
IP_ECHO = "https://api.ipify.org"
BLOCK_CODES = {403, 429}
BLOCK_PHRASES = ("verify you are human", "are you a robot", "unusual traffic", "access denied", "не робот")
PAUSE = (1.5, 3.5)
MAX_ATTEMPTS = 3
ROTATE_TIMEOUT = 90
REFUSED_WAIT = 60
ROTATE_TRIES = 3
HEADERS = {
    "User-Agent": "Mozilla/5.0 (Linux; Android 13; Pixel 7) AppleWebKit/537.36 "
    "(KHTML, like Gecko) Chrome/126.0 Mobile Safari/537.36",
}

write_lock = threading.Lock()


def exit_ip(session):
    try:
        return session.get(IP_ECHO, timeout=15).text.strip()
    except requests.RequestException:
        return None


def request_change(proxy):
    for attempt in range(ROTATE_TRIES):
        if attempt:
            time.sleep(REFUSED_WAIT)
        try:
            answer = requests.get(proxy["rotate_url"], timeout=15).json()
        except (requests.RequestException, ValueError):
            answer = {}
        if answer.get("result") == "Success":
            return True
    return False


def rotate(proxy, session):
    previous = exit_ip(session)
    if not request_change(proxy):
        return False
    deadline = time.time() + ROTATE_TIMEOUT
    while time.time() < deadline:
        time.sleep(5)
        current = exit_ip(session)
        if current and current != previous:
            return True
    return False


def visible_text(html):
    html = re.sub(r"(?is)<(script|style)\b.*?</\1>", " ", html[:20000])
    return re.sub(r"<[^>]+>", " ", html).lower()


def blocked(response):
    if response.status_code in BLOCK_CODES:
        return True
    text = visible_text(response.text)
    return any(phrase in text for phrase in BLOCK_PHRASES)


def handle(session, proxy, stats, tasks, url, attempt):
    record = {
        "at": datetime.now(timezone.utc).isoformat(timespec="seconds"),
        "url": url,
        "proxy": proxy["name"],
        "attempt": attempt,
    }
    retry = False
    usable = True
    try:
        response = session.get(url, timeout=30)
        stats["requests"] += 1
        record["status"] = response.status_code
        if blocked(response):
            stats["blocks"] += 1
            record["state"] = "blocked"
            retry = True
            session.cookies.clear()
            if rotate(proxy, session):
                stats["rotations"] += 1
            else:
                usable = False
        else:
            record["state"] = "ok"
            record["bytes"] = len(response.content)
    except requests.RequestException as error:
        record["state"] = f"error: {type(error).__name__}"
        retry = True
    if retry and attempt < MAX_ATTEMPTS:
        tasks.put((url, attempt + 1))
    return record, usable


def worker(proxy, tasks, results):
    session = requests.Session()
    session.proxies = {"http": proxy["proxy"], "https": proxy["proxy"]}
    session.headers.update(HEADERS)
    stats = {"name": proxy["name"], "requests": 0, "blocks": 0, "rotations": 0}
    while True:
        try:
            url, attempt = tasks.get(timeout=1)
        except queue.Empty:
            if tasks.unfinished_tasks == 0:
                return stats
            continue
        try:
            record, usable = handle(session, proxy, stats, tasks, url, attempt)
        finally:
            tasks.task_done()
        with write_lock:
            results.write(json.dumps(record, ensure_ascii=False) + "\n")
            results.flush()
        if not usable:
            print(f"{proxy['name']}: IP did not change, the proxy leaves the pool")
            return stats
        time.sleep(random.uniform(*PAUSE))


def main():
    with open(PROXIES_FILE, newline="") as f:
        pool = list(csv.DictReader(f))
    tasks = queue.Queue()
    with open(URLS_FILE) as f:
        for line in f:
            if line.strip():
                tasks.put((line.strip(), 1))

    with open(RESULTS_FILE, "a") as results, ThreadPoolExecutor(len(pool)) as executor:
        summary = list(executor.map(lambda proxy: worker(proxy, tasks, results), pool))

    print(f"{'proxy':<12}{'requests':>10}{'blocks':>8}{'rotations':>11}")
    for row in summary:
        print(f"{row['name']:<12}{row['requests']:>10}{row['blocks']:>8}{row['rotations']:>11}")
    if tasks.qsize():
        print(f"{tasks.qsize()} URLs left: every proxy in the pool is blocked")


if __name__ == "__main__":
    main()
ลิงก์เปลี่ยน IP ตอบด้วยรหัส 200 และเขียน Success หรือ Failure ในเนื้อหา Failure จะเกิดขึ้น เช่น เมื่อขอเปลี่ยนบ่อยเกินไป: สคริปต์จะรอหนึ่งนาทีแล้วลองอีกสองครั้ง ระหว่างที่โทรศัพท์อยู่ในโหมดเครื่องบิน พร็อกซี่ของเครื่องนั้นจะเข้าถึงไม่ได้ การเปลี่ยนแต่ละครั้งจึงใช้เวลาหลายสิบวินาที
ควรเลือกแพ็กเกจไหนสำหรับ scraping
สำหรับ scraping ความต่างระหว่างแพ็กเกจอยู่ที่ความเร็วและการประหยัดทราฟฟิก
ทดสอบเว็บไซต์และดีบักสคริปต์
ความเร็วสูงสุด 5 Mbps เพียงพอที่จะดูว่าเว็บไซต์ตอบสนองต่อที่อยู่มือถืออย่างไร และดีบัก scraper กับรายการหน้าสั้น ๆ
- $4 ต่ออุปกรณ์ สำหรับ 30 วัน
- ความเร็วสูงสุด 5 Mbps
- เปลี่ยน IP ผ่านลิงก์และตามตัวจับเวลา
- เข้าใช้ด้วยล็อกอินหรือรายการ IP ที่อนุญาต
การเก็บข้อมูลต่อเนื่อง
สูงสุด 100 Mbps ต่ออุปกรณ์ พร้อม IP เฉพาะ และ SmartRelay: โทรศัพท์ดาวน์โหลดหน้าเว็บผ่านเครือข่ายมือถือและส่งไปยังเซิร์ฟเวอร์ผ่าน Wi‑Fi แพ็กเกจเน็ตของซิมจึงหมดช้าลงราวครึ่งหนึ่ง
- $7 ต่ออุปกรณ์ สำหรับ 30 วัน
- ความเร็วสูงสุด 100 Mbps
- IP เฉพาะหลังการเปลี่ยน
- SmartRelay และส่วนลดตามจำนวน
เก็บข้อมูลอย่างไรไม่ให้ที่อยู่เสีย
ข้อมูลสาธารณะเท่านั้น
เก็บเฉพาะสิ่งที่เว็บไซต์แสดงโดยไม่ต้องเข้าสู่ระบบ ปฏิบัติตามเงื่อนไขของเว็บไซต์และกฎหมายคุ้มครองข้อมูลส่วนบุคคล การเปลี่ยนที่อยู่ไม่ได้ทำให้การเก็บข้อมูลที่ต้องห้ามกลายเป็นเรื่องถูกกฎหมาย
จังหวะสำคัญกว่าการหมุน IP
เว็บไซต์สังเกตจังหวะก่อนที่อยู่ การพักแบบสุ่มระหว่างคำขอลดการบล็อกได้มากกว่าการเปลี่ยน IP บ่อย ๆ
คุกกี้ผูกกับที่อยู่
หากเว็บไซต์ตั้งคุกกี้ตั้งแต่การเข้าครั้งแรก ให้เก็บไว้ในเซสชันของพร็อกซี่ตัวเดียว และล้างทุกครั้งที่เปลี่ยน IP คุกกี้ที่ออกให้ที่อยู่หนึ่งแต่มาจากอีกที่อยู่หนึ่งดูน่าสงสัย
ผู้ให้บริการเครือข่ายหลายรายในพูล
ซิมการ์ดจากผู้ให้บริการเครือข่ายสองหรือสามรายให้ที่อยู่จากซับเน็ตต่างกัน และพูลจะไม่หยุดทั้งหมดหากผู้ให้บริการรายหนึ่งมีปัญหา
เฉพาะข้อมูลที่จำเป็น
หน้าเว็บที่มีรูปภาพและสคริปต์มีขนาดหลายเมกะไบต์ ขอเฉพาะ HTML หรือ API ของเว็บไซต์โดยไม่โหลดทรัพยากรส่วนเกิน และบน Professional ให้ตั้งขีดจำกัดทราฟฟิกให้การเชื่อมต่อ
คำถามและคำตอบ
เปลี่ยน IP ผ่านลิงก์ได้บ่อยแค่ไหน?
ควรให้ scraper วิ่งผ่านโทรศัพท์หนึ่งเครื่องกี่เธรด?
พร็อกซี่ใช้กับ Selenium และ Playwright ได้ไหม?
ดึงข้อมูลจากเว็บไซต์ที่เปิดได้เฉพาะในประเทศเดียวได้ไหม?
ทำไมเว็บไซต์ยังบล็อกต่อหลังเปลี่ยน IP?
พร็อกซี่มือถือดีกว่าพร็อกซี่เซิร์ฟเวอร์สำหรับ scraping อย่างไร?
พร็อกซี่มือถือสำหรับงานอื่น
ทดสอบเว็บไซต์ของคุณบน IP มือถือ
ฝ่ายสนับสนุนให้ลูกค้าใหม่ใช้งานฟรี 24 ชั่วโมง เชื่อมต่อโทรศัพท์ รันสคริปต์กับรายการหน้าสั้น ๆ แล้วดูว่ายังเหลือการบล็อกเท่าไร
