Proxies móviles para web scraping
Un scraper necesita una dirección que el sitio no corte en las primeras cien solicitudes. Cientos de abonados comparten la IP externa de un operador, así que bloquearla le sale demasiado caro al sitio. En Mobihub los proxies funcionan en tus propios teléfonos: la IP cambia con un enlace desde tu script o por temporizador, y HTTP y SOCKS5 comparten un mismo puerto.
- desde 3 min
- intervalo del cambio de IP por temporizador
- 1 enlace
- cambio de IP desde tu script
- HTTP + SOCKS5
- en un mismo puerto
- 100 Mbps
- de velocidad en el plan Professional
Por qué los scrapers chocan con bloqueos
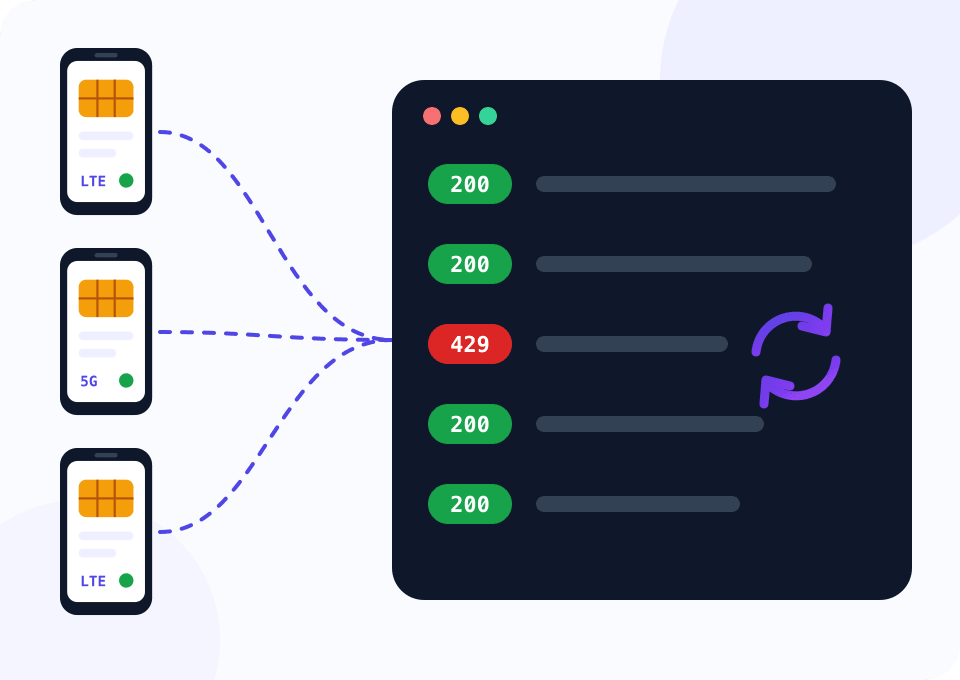
Los sitios web cuentan las solicitudes de cada dirección. Las subredes de centros de datos llevan tiempo en listas, y un sitio protegido suele recibir esa IP con un captcha desde la primera solicitud. Incluso una dirección limpia recibe un 429 o una página de verificación tras unos cientos de visitas.
Una dirección móvil es más cara de bloquear: detrás de ella hay abonados comunes del operador. Si aun así se alcanza el límite, la IP cambia con un enlace: el teléfono pasa unos segundos en modo avión y vuelve a conectarse con una nueva dirección del operador.
Para volumen hace falta un pool de varios teléfonos. El script de abajo reparte las URL de las páginas entre los proxies y cambia la IP solo en el que fue bloqueado, mientras los demás siguen trabajando.
Un pool de cinco teléfonos por un mes
El widget se abre en Professional, con cinco dispositivos y 30 días. Para scraping, la diferencia principal del plan es la velocidad: hasta 100 Mbps en lugar de 5 Mbps en Beginner. Cinco dispositivos dan un descuento por volumen, y la fila “Por dispositivo / mes” muestra el costo de un proxy.
Cómo conectar un pool a un scraper
Los pasos son los mismos para dos teléfonos y para veinte.
Conecta los teléfonos
Instala Mobihub en teléfonos Android con SIM de dos o tres operadores y crea en cada uno un proxy con el plan Professional.
Activa IP única
Al cambiar la dirección, el teléfono hace varios intentos hasta obtener una IP que este proxy todavía no ha tenido; el número de intentos se fija en la configuración. El scraper cae con menos frecuencia en una dirección que el sitio bloqueó hace poco.
Arma proxies.csv
Para cada proxy, toma del panel la dirección de conexión y el enlace de cambio de IP. El archivo tiene tres columnas: name, proxy y rotate_url.
Define el ritmo
Empieza con una pausa de dos a tres segundos entre solicitudes a través de un mismo teléfono y súbela si los bloqueos son frecuentes. Cambiar la IP a menudo no sustituye un ritmo tranquilo.
Ejecuta el script y lee el resumen
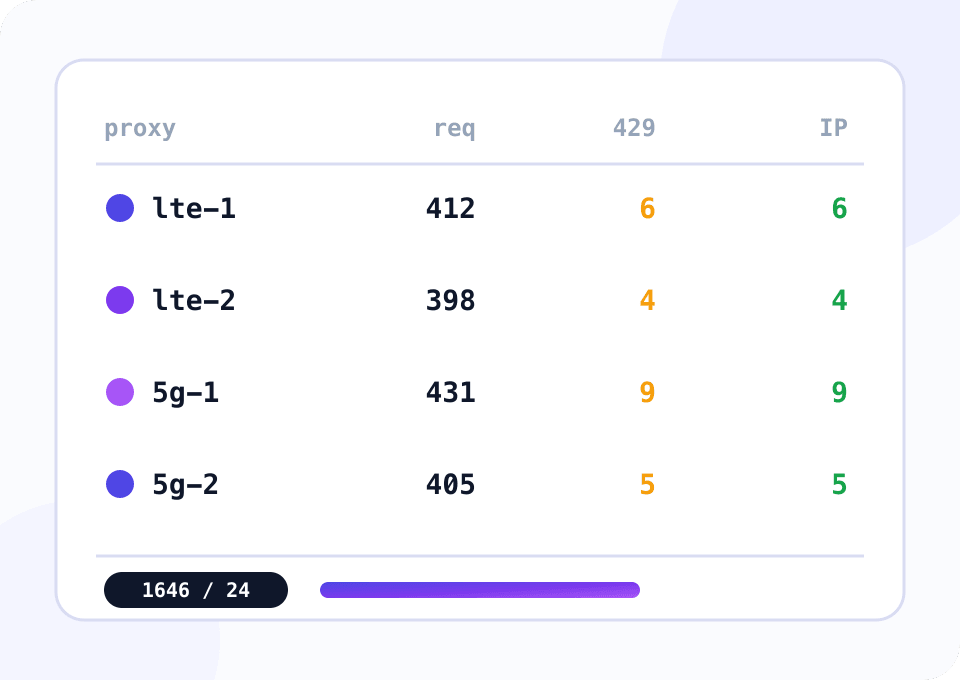
Cada intento se guarda en results.jsonl. Al final, el script muestra el número de solicitudes, bloqueos y cambios de IP de cada proxy.
Script: scraping con un pool que rota al ser bloqueado
El script reparte las URL de urls.txt entre los proxies de proxies.csv, un hilo por teléfono. Un 403, un 429 o una página de captcha cuentan como bloqueo: la URL vuelve a la cola, se borran las cookies y se llama al enlace de cambio de IP del proxy. El script espera la nueva dirección y continúa mientras los demás teléfonos siguen trabajando. Si la IP no logra cambiar, el teléfono sale del pool y los demás toman sus URL. Un script de reCAPTCHA en el código de la página no cuenta como bloqueo: el script busca el texto de verificación que ve una persona.
import csv
import json
import queue
import random
import re
import threading
import time
from concurrent.futures import ThreadPoolExecutor
from datetime import datetime, timezone

import requests

PROXIES_FILE = "proxies.csv"
URLS_FILE = "urls.txt"
RESULTS_FILE = "results.jsonl"
IP_ECHO = "https://api.ipify.org"
BLOCK_CODES = {403, 429}
BLOCK_PHRASES = ("verify you are human", "are you a robot", "unusual traffic", "access denied", "не робот")
PAUSE = (1.5, 3.5)
MAX_ATTEMPTS = 3
ROTATE_TIMEOUT = 90
REFUSED_WAIT = 60
ROTATE_TRIES = 3
HEADERS = {
    "User-Agent": "Mozilla/5.0 (Linux; Android 13; Pixel 7) AppleWebKit/537.36 "
    "(KHTML, like Gecko) Chrome/126.0 Mobile Safari/537.36",
}

write_lock = threading.Lock()


def exit_ip(session):
    try:
        return session.get(IP_ECHO, timeout=15).text.strip()
    except requests.RequestException:
        return None


def request_change(proxy):
    for attempt in range(ROTATE_TRIES):
        if attempt:
            time.sleep(REFUSED_WAIT)
        try:
            answer = requests.get(proxy["rotate_url"], timeout=15).json()
        except (requests.RequestException, ValueError):
            answer = {}
        if answer.get("result") == "Success":
            return True
    return False


def rotate(proxy, session):
    previous = exit_ip(session)
    if not request_change(proxy):
        return False
    deadline = time.time() + ROTATE_TIMEOUT
    while time.time() < deadline:
        time.sleep(5)
        current = exit_ip(session)
        if current and current != previous:
            return True
    return False


def visible_text(html):
    html = re.sub(r"(?is)<(script|style)\b.*?</\1>", " ", html[:20000])
    return re.sub(r"<[^>]+>", " ", html).lower()


def blocked(response):
    if response.status_code in BLOCK_CODES:
        return True
    text = visible_text(response.text)
    return any(phrase in text for phrase in BLOCK_PHRASES)


def handle(session, proxy, stats, tasks, url, attempt):
    record = {
        "at": datetime.now(timezone.utc).isoformat(timespec="seconds"),
        "url": url,
        "proxy": proxy["name"],
        "attempt": attempt,
    }
    retry = False
    usable = True
    try:
        response = session.get(url, timeout=30)
        stats["requests"] += 1
        record["status"] = response.status_code
        if blocked(response):
            stats["blocks"] += 1
            record["state"] = "blocked"
            retry = True
            session.cookies.clear()
            if rotate(proxy, session):
                stats["rotations"] += 1
            else:
                usable = False
        else:
            record["state"] = "ok"
            record["bytes"] = len(response.content)
    except requests.RequestException as error:
        record["state"] = f"error: {type(error).__name__}"
        retry = True
    if retry and attempt < MAX_ATTEMPTS:
        tasks.put((url, attempt + 1))
    return record, usable


def worker(proxy, tasks, results):
    session = requests.Session()
    session.proxies = {"http": proxy["proxy"], "https": proxy["proxy"]}
    session.headers.update(HEADERS)
    stats = {"name": proxy["name"], "requests": 0, "blocks": 0, "rotations": 0}
    while True:
        try:
            url, attempt = tasks.get(timeout=1)
        except queue.Empty:
            if tasks.unfinished_tasks == 0:
                return stats
            continue
        try:
            record, usable = handle(session, proxy, stats, tasks, url, attempt)
        finally:
            tasks.task_done()
        with write_lock:
            results.write(json.dumps(record, ensure_ascii=False) + "\n")
            results.flush()
        if not usable:
            print(f"{proxy['name']}: IP did not change, the proxy leaves the pool")
            return stats
        time.sleep(random.uniform(*PAUSE))


def main():
    with open(PROXIES_FILE, newline="") as f:
        pool = list(csv.DictReader(f))
    tasks = queue.Queue()
    with open(URLS_FILE) as f:
        for line in f:
            if line.strip():
                tasks.put((line.strip(), 1))

    with open(RESULTS_FILE, "a") as results, ThreadPoolExecutor(len(pool)) as executor:
        summary = list(executor.map(lambda proxy: worker(proxy, tasks, results), pool))

    print(f"{'proxy':<12}{'requests':>10}{'blocks':>8}{'rotations':>11}")
    for row in summary:
        print(f"{row['name']:<12}{row['requests']:>10}{row['blocks']:>8}{row['rotations']:>11}")
    if tasks.qsize():
        print(f"{tasks.qsize()} URLs left: every proxy in the pool is blocked")


if __name__ == "__main__":
    main()
El enlace de cambio de IP responde con el código 200 y escribe Success o Failure en el cuerpo. Failure llega, por ejemplo, cuando se piden cambios con demasiada frecuencia: el script espera un minuto y lo intenta dos veces más. Mientras el teléfono está en modo avión, su proxy no responde, así que un cambio tarda decenas de segundos.
Qué plan elegir para scraping
Para scraping, la diferencia entre los planes se reduce a la velocidad y al ahorro de tráfico.
Probar el sitio y depurar el script
Hasta 5 Mbps bastan para ver cómo reacciona el sitio a una dirección móvil y depurar el scraper con una lista corta de páginas.
- $4 por dispositivo por 30 días
- Velocidad de hasta 5 Mbps
- Cambio de IP por enlace y por temporizador
- Acceso con usuario o lista de IP permitidas
Recolección de datos continua
Hasta 100 Mbps por dispositivo, IP única y SmartRelay: el teléfono descarga las páginas por la red móvil y las envía al servidor por Wi‑Fi, así que el plan de datos de la SIM se gasta aproximadamente la mitad de rápido.
- $7 por dispositivo por 30 días
- Velocidad de hasta 100 Mbps
- IP única tras cada cambio
- SmartRelay y descuento por volumen
Cómo recolectar datos sin quemar direcciones
Solo datos públicos
Recolecta lo que el sitio muestra sin iniciar sesión, respeta sus términos y las leyes de datos personales. Cambiar la dirección no vuelve legal una recolección prohibida.
El ritmo importa más que la rotación
Un sitio nota el ritmo antes que la dirección. Una pausa aleatoria entre solicitudes reduce los bloqueos más que cambiar la IP a menudo.
Las cookies van con la dirección
Si el sitio pone cookies en la primera visita, mantenlas en la sesión de un solo proxy y bórralas con cada cambio de IP. Unas cookies emitidas para una dirección que llegan desde otra resultan sospechosas.
Varios operadores en el pool
Las SIM de dos o tres operadores dan direcciones de subredes distintas, y el pool no se detiene por completo si un operador tiene problemas.
Solo los bytes que necesitas
Una página con imágenes y scripts pesa megabytes. Pide el HTML o la API del sitio sin recursos extra y, en Professional, pon un límite de tráfico a la conexión.
Preguntas y respuestas
¿Con qué frecuencia se puede cambiar la IP por enlace?
¿Cuántos hilos del scraper deben pasar por un teléfono?
¿Los proxies funcionan con Selenium y Playwright?
¿Puedo hacer scraping de sitios que solo abren desde un país?
¿Por qué el sitio sigue bloqueando después de cambiar la IP?
¿Qué hace que un proxy móvil sea mejor para scraping que uno de servidor?
Proxies móviles para otras tareas
Prueba tu sitio con una IP móvil
Soporte da a los clientes nuevos 24 horas de acceso gratis. Conecta un teléfono, ejecuta el script con una lista corta de páginas y mira cuántos bloqueos quedan.
