Proxys mobiles pour le web scraping
Un scraper a besoin d'une adresse que le site ne coupera pas dès la première centaine de requêtes. Des centaines d'abonnés partagent l'IP externe d'un opérateur, et la bloquer coûte trop cher au site. Chez Mobihub, les proxys tournent sur vos propres téléphones : l'IP change par un lien depuis votre script ou par minuterie, et HTTP et SOCKS5 partagent un seul port.
- dès 3 min
- intervalle de changement d'IP par minuterie
- 1 lien
- changement d'IP depuis votre script
- HTTP + SOCKS5
- sur un seul port
- 100 Mbps
- vitesse sur le forfait Professional
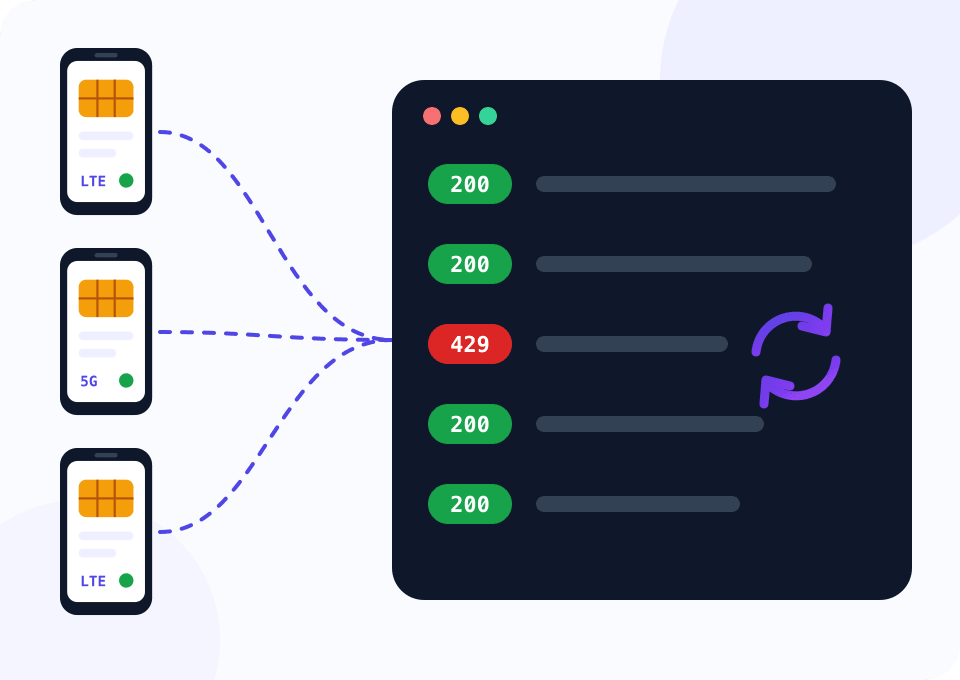
Pourquoi les scrapers se font bloquer
Les sites comptent les requêtes de chaque adresse. Les sous-réseaux des data centers sont fichés depuis longtemps, et un site protégé accueille souvent une telle IP par un captcha dès la première requête. Même une adresse propre reçoit un 429 ou une page de vérification après quelques centaines d'accès.
Une adresse mobile coûte plus cher à bloquer : derrière elle se trouvent des abonnés ordinaires de l'opérateur. Si la limite est quand même atteinte, l'IP change par un lien : le téléphone passe en mode avion quelques secondes et revient en ligne avec une nouvelle adresse de l'opérateur.
Le volume demande un pool de plusieurs téléphones. Le script ci-dessous répartit les URL des pages entre les proxys et ne change l'IP que sur celui qui a été bloqué, pendant que les autres continuent de travailler.
Un pool de cinq téléphones pour un mois
Le widget s'ouvre sur Professional, cinq appareils et 30 jours. Pour le scraping, la principale différence du forfait est la vitesse : jusqu'à 100 Mbps au lieu de 5 Mbps sur Beginner. Cinq appareils donnent droit à une remise sur volume, et la ligne « Par appareil / mois » montre le coût d'un proxy.
Comment brancher un pool sur un scraper
Les étapes sont les mêmes pour deux téléphones comme pour vingt.
Connectez les téléphones
Installez Mobihub sur des téléphones Android avec des cartes SIM de deux ou trois opérateurs et créez sur chacun un proxy au forfait Professional.
Activez l'IP unique
Lors du changement d'adresse, le téléphone fait plusieurs tentatives jusqu'à obtenir une IP que ce proxy n'a pas encore eue ; le nombre de tentatives se règle dans les paramètres. Le scraper tombe moins souvent sur une adresse que le site a récemment bloquée.
Préparez proxies.csv
Pour chaque proxy, prenez l'adresse de connexion et le lien de changement d'IP dans l'espace client. Le fichier a trois colonnes : name, proxy et rotate_url.
Réglez le rythme
Commencez par une pause de deux à trois secondes entre les requêtes via un même téléphone et augmentez-la si les blocages sont fréquents. Des changements d'IP fréquents ne remplacent pas un rythme calme.
Lancez le script et lisez le bilan
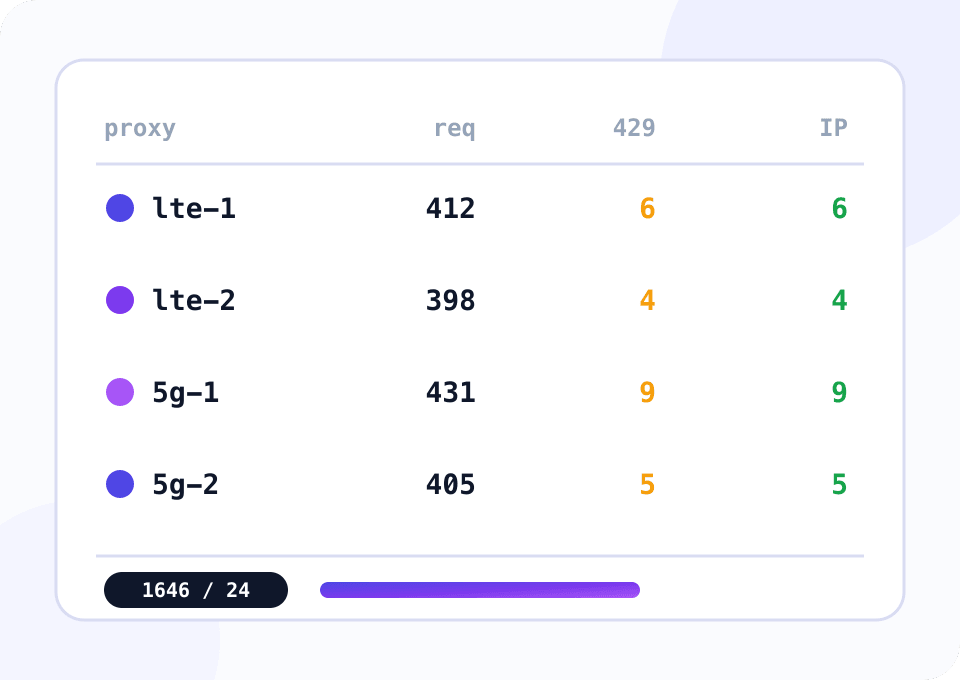
Chaque tentative est écrite dans results.jsonl. À la fin, le script affiche le nombre de requêtes, de blocages et de changements d'IP pour chaque proxy.
Script : scraping via un pool qui change d'IP sur blocage
Le script répartit les URL de urls.txt entre les proxys de proxies.csv, un thread par téléphone. Un 403, un 429 ou une page de captcha compte comme un blocage : l'URL retourne dans la file, les cookies sont effacés et le lien de changement d'IP du proxy est appelé. Le script attend la nouvelle adresse et reprend pendant que les autres téléphones continuent. Si l'IP ne change pas, le téléphone quitte le pool et les autres reprennent ses URL. Un script reCAPTCHA dans le code de la page ne compte pas comme un blocage : le script cherche le texte de vérification que voit une personne.
import csv
import json
import queue
import random
import re
import threading
import time
from concurrent.futures import ThreadPoolExecutor
from datetime import datetime, timezone

import requests

PROXIES_FILE = "proxies.csv"
URLS_FILE = "urls.txt"
RESULTS_FILE = "results.jsonl"
IP_ECHO = "https://api.ipify.org"
BLOCK_CODES = {403, 429}
BLOCK_PHRASES = ("verify you are human", "are you a robot", "unusual traffic", "access denied", "не робот")
PAUSE = (1.5, 3.5)
MAX_ATTEMPTS = 3
ROTATE_TIMEOUT = 90
REFUSED_WAIT = 60
ROTATE_TRIES = 3
HEADERS = {
    "User-Agent": "Mozilla/5.0 (Linux; Android 13; Pixel 7) AppleWebKit/537.36 "
    "(KHTML, like Gecko) Chrome/126.0 Mobile Safari/537.36",
}

write_lock = threading.Lock()


def exit_ip(session):
    try:
        return session.get(IP_ECHO, timeout=15).text.strip()
    except requests.RequestException:
        return None


def request_change(proxy):
    for attempt in range(ROTATE_TRIES):
        if attempt:
            time.sleep(REFUSED_WAIT)
        try:
            answer = requests.get(proxy["rotate_url"], timeout=15).json()
        except (requests.RequestException, ValueError):
            answer = {}
        if answer.get("result") == "Success":
            return True
    return False


def rotate(proxy, session):
    previous = exit_ip(session)
    if not request_change(proxy):
        return False
    deadline = time.time() + ROTATE_TIMEOUT
    while time.time() < deadline:
        time.sleep(5)
        current = exit_ip(session)
        if current and current != previous:
            return True
    return False


def visible_text(html):
    html = re.sub(r"(?is)<(script|style)\b.*?</\1>", " ", html[:20000])
    return re.sub(r"<[^>]+>", " ", html).lower()


def blocked(response):
    if response.status_code in BLOCK_CODES:
        return True
    text = visible_text(response.text)
    return any(phrase in text for phrase in BLOCK_PHRASES)


def handle(session, proxy, stats, tasks, url, attempt):
    record = {
        "at": datetime.now(timezone.utc).isoformat(timespec="seconds"),
        "url": url,
        "proxy": proxy["name"],
        "attempt": attempt,
    }
    retry = False
    usable = True
    try:
        response = session.get(url, timeout=30)
        stats["requests"] += 1
        record["status"] = response.status_code
        if blocked(response):
            stats["blocks"] += 1
            record["state"] = "blocked"
            retry = True
            session.cookies.clear()
            if rotate(proxy, session):
                stats["rotations"] += 1
            else:
                usable = False
        else:
            record["state"] = "ok"
            record["bytes"] = len(response.content)
    except requests.RequestException as error:
        record["state"] = f"error: {type(error).__name__}"
        retry = True
    if retry and attempt < MAX_ATTEMPTS:
        tasks.put((url, attempt + 1))
    return record, usable


def worker(proxy, tasks, results):
    session = requests.Session()
    session.proxies = {"http": proxy["proxy"], "https": proxy["proxy"]}
    session.headers.update(HEADERS)
    stats = {"name": proxy["name"], "requests": 0, "blocks": 0, "rotations": 0}
    while True:
        try:
            url, attempt = tasks.get(timeout=1)
        except queue.Empty:
            if tasks.unfinished_tasks == 0:
                return stats
            continue
        try:
            record, usable = handle(session, proxy, stats, tasks, url, attempt)
        finally:
            tasks.task_done()
        with write_lock:
            results.write(json.dumps(record, ensure_ascii=False) + "\n")
            results.flush()
        if not usable:
            print(f"{proxy['name']}: IP did not change, the proxy leaves the pool")
            return stats
        time.sleep(random.uniform(*PAUSE))


def main():
    with open(PROXIES_FILE, newline="") as f:
        pool = list(csv.DictReader(f))
    tasks = queue.Queue()
    with open(URLS_FILE) as f:
        for line in f:
            if line.strip():
                tasks.put((line.strip(), 1))

    with open(RESULTS_FILE, "a") as results, ThreadPoolExecutor(len(pool)) as executor:
        summary = list(executor.map(lambda proxy: worker(proxy, tasks, results), pool))

    print(f"{'proxy':<12}{'requests':>10}{'blocks':>8}{'rotations':>11}")
    for row in summary:
        print(f"{row['name']:<12}{row['requests']:>10}{row['blocks']:>8}{row['rotations']:>11}")
    if tasks.qsize():
        print(f"{tasks.qsize()} URLs left: every proxy in the pool is blocked")


if __name__ == "__main__":
    main()
Le lien de changement d'IP répond avec le code 200 et écrit Success ou Failure dans le corps. Failure arrive par exemple quand les changements sont demandés trop souvent : le script attend une minute et réessaie deux fois. Tant que le téléphone est en mode avion, son proxy est injoignable, donc un changement prend quelques dizaines de secondes.
Quel forfait choisir pour le scraping
Pour le scraping, la différence entre les forfaits se résume à la vitesse et aux économies de trafic.
Tester le site et déboguer le script
Jusqu'à 5 Mbps suffisent pour voir comment le site réagit à une adresse mobile et pour déboguer le scraper sur une courte liste de pages.
- $4 par appareil pour 30 jours
- Vitesse jusqu'à 5 Mbps
- Changement d'IP par lien et par minuterie
- Accès par identifiant ou liste d'IP autorisées
Collecte de données en continu
Jusqu'à 100 Mbps par appareil, IP unique et SmartRelay : le téléphone télécharge les pages via le réseau mobile et les envoie au serveur via le Wi‑Fi, si bien que le forfait de la SIM s'épuise environ deux fois moins vite.
- $7 par appareil pour 30 jours
- Vitesse jusqu'à 100 Mbps
- IP unique après un changement
- SmartRelay et remise sur volume
Collecter des données sans griller les adresses
Uniquement des données publiques
Collectez ce que le site affiche sans connexion, respectez ses conditions et les lois sur les données personnelles. Changer d'adresse ne rend pas légale une collecte interdite.
Le rythme compte plus que la rotation
Un site remarque le rythme avant l'adresse. Une pause aléatoire entre les requêtes réduit davantage les blocages que des changements d'IP fréquents.
Les cookies appartiennent à une adresse
Si le site pose des cookies à la première visite, gardez-les dans la session d'un seul proxy et effacez-les à chaque changement d'IP. Des cookies émis pour une adresse qui arrivent d'une autre paraissent suspects.
Plusieurs opérateurs dans le pool
Des cartes SIM de deux ou trois opérateurs donnent des adresses de sous-réseaux différents, et le pool ne s'arrête pas complètement si un opérateur a un souci.
Seulement les octets utiles
Une page avec images et scripts pèse des mégaoctets. Demandez le HTML ou l'API du site sans ressources superflues, et en Professional fixez une limite de trafic sur la connexion.
Questions et réponses
À quelle fréquence peut-on changer l'IP par lien ?
Combien de threads de scraper faire passer par un téléphone ?
Les proxys fonctionnent-ils avec Selenium et Playwright ?
Puis-je scraper des sites accessibles depuis un seul pays ?
Pourquoi le site bloque-t-il encore après un changement d'IP ?
En quoi un proxy mobile est-il meilleur qu'un proxy serveur pour le scraping ?
Proxys mobiles pour d'autres usages
Testez votre site sur une IP mobile
Le support offre 24 heures d'accès gratuit aux nouveaux clients. Connectez un téléphone, lancez le script sur une courte liste de pages et voyez combien de blocages il reste.
