SEO 专员为什么需要移动地址
搜索引擎会考虑用户所在地区,而且移动端结果与桌面端不同。从办公室 IP 检查,看到的是办公室所在地的排名,而客户关心的是本市拿着手机的顾客看到了什么。
网站的响应也可能不同。反爬虫防护有时会屏蔽运营商网段,CDN 在某个地区提供过期的副本,按地区跳转把移动访客送到错误的版本。这些从办公室电脑上都看不出来。
在 Mobihub 中,代理运行在您插有所需运营商 SIM 卡的手机上。通过这种代理的浏览器,会以该运营商移动用户的视角看到搜索结果和网站。
两家运营商,用一个月
计算器默认打开 Beginner 套餐和两台设备。最高 5 Mbps 足以手动检查搜索结果和审核您的页面,两部插着不同运营商 SIM 卡的手机能显示网络之间的差异。如果要覆盖更多地区,每个地区再加一部手机。
如何通过移动代理检查搜索结果和您的网站
手动查看搜索结果和自动审核页面,两者相辅相成。
在目标地区连接手机
在插有受众常用运营商 SIM 卡的 Android 手机上安装 Mobihub,并在其上创建代理。
设置独立的浏览器配置文件
把代理放进单独的浏览器配置文件或指纹浏览器中,以免工作浏览器的历史记录和 cookies 影响搜索结果。
手动检查搜索结果
把浏览器切换到移动模式,将排名和摘要与排名跟踪工具的报告对比。搜索引擎会很快用验证拦下自动化的结果采集,所以我们不为它写脚本。
审核您的页面
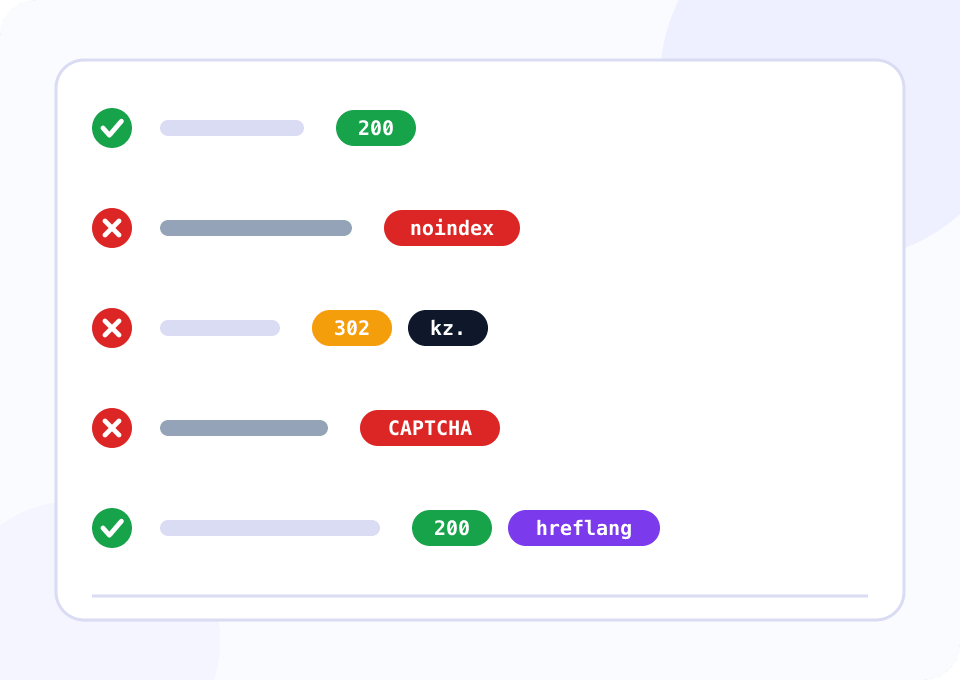
下面的脚本会通过代理遍历您的页面,显示移动访客得到的内容:状态码、最终地址、canonical、hreflang 和 noindex。
对比运营商
通过不同运营商的手机运行脚本并对比报告。状态码和最终地址的差异,说明问题出在反爬虫防护、CDN 或按地区跳转上。
脚本:移动访客在您的页面上得到什么
脚本从 pages.txt 读取 URL,以智能手机 User-Agent 通过移动代理逐个打开,并记录状态码、最终地址、title、canonical、hreflang,以及 meta robots 和 X-Robots-Tag 响应头中的 noindex。脚本会标记“请验证您是真人”页面、跳转到其他主机、指向别处的 canonical 以及没有 viewport 的页面,输出这些页面并以代码 1 退出。
import csv
import re
from html.parser import HTMLParser
from urllib.parse import urljoin, urlparse

import requests

PROXY = "http://LOGIN:PASSWORD@HOST:PORT"
PAGES_FILE = "pages.txt"
REPORT_FILE = "seo_mobile_report.csv"
ACCEPT_LANGUAGE = "ru-RU,ru;q=0.9"
BLOCK_PHRASES = ("verify you are human", "are you a robot", "unusual traffic", "access denied", "не робот")
HEADERS = {
    "User-Agent": "Mozilla/5.0 (Linux; Android 14; Pixel 8) AppleWebKit/537.36 "
    "(KHTML, like Gecko) Chrome/126.0 Mobile Safari/537.36",
    "Accept-Language": ACCEPT_LANGUAGE,
}

proxies = {"http": PROXY, "https": PROXY}


class HeadParser(HTMLParser):
    def __init__(self):
        super().__init__()
        self.title = ""
        self.canonical = ""
        self.robots = ""
        self.hreflang = []
        self.viewport = False
        self.in_title = False

    def handle_starttag(self, tag, attrs):
        attrs = {key.lower(): value or "" for key, value in attrs}
        if tag == "title":
            self.in_title = True
        elif tag == "link":
            rel = attrs.get("rel", "").lower().split()
            if "canonical" in rel:
                self.canonical = attrs.get("href", "")
            if "alternate" in rel and attrs.get("hreflang"):
                self.hreflang.append(attrs["hreflang"])
        elif tag == "meta":
            name = attrs.get("name", "").lower()
            if name in ("robots", "googlebot", "yandex"):
                self.robots += " " + attrs.get("content", "").lower()
            if name == "viewport":
                self.viewport = True

    def handle_endtag(self, tag):
        if tag == "title":
            self.in_title = False

    def handle_data(self, data):
        if self.in_title:
            self.title += data


def visible_text(html):
    html = re.sub(r"(?is)<(script|style)\b.*?</\1>", " ", html[:20000])
    return re.sub(r"<[^>]+>", " ", html).lower()


def host(url):
    name = urlparse(url).hostname or ""
    return name[4:] if name.startswith("www.") else name


def audit(url):
    row = {"url": url, "status": "", "final_url": "", "title": "", "canonical": "", "hreflang": "", "robots": "", "issues": ""}
    try:
        response = requests.get(url, headers=HEADERS, proxies=proxies, timeout=30)
    except requests.RequestException as error:
        row.update(status="error", issues=type(error).__name__)
        return row

    page = HeadParser()
    page.feed(response.text)
    robots = (page.robots + " " + response.headers.get("X-Robots-Tag", "").lower()).strip()
    canonical = urljoin(response.url, page.canonical) if page.canonical else ""
    issues = []
    if response.status_code != 200:
        issues.append(f"status {response.status_code}")
    if any(phrase in visible_text(response.text) for phrase in BLOCK_PHRASES):
        issues.append("captcha or block page for this carrier")
    if host(response.url) != host(url):
        issues.append("redirected to another host")
    if "noindex" in robots:
        issues.append("noindex")
    if not canonical:
        issues.append("no canonical")
    elif host(canonical) != host(response.url):
        issues.append("canonical points to another host")
    if not page.viewport:
        issues.append("no viewport meta")

    row.update(
        status=response.status_code,
        final_url=response.url,
        title=" ".join(page.title.split())[:80],
        canonical=canonical,
        hreflang=",".join(page.hreflang),
        robots=robots,
        issues="; ".join(issues),
    )
    return row


def main():
    with open(PAGES_FILE) as f:
        urls = [line.strip() for line in f if line.strip()]

    if not urls:
        raise SystemExit(f"{PAGES_FILE} is empty")
    rows = [audit(url) for url in urls]
    with open(REPORT_FILE, "w", newline="") as f:
        writer = csv.DictWriter(f, fieldnames=list(rows[0].keys()))
        writer.writeheader()
        writer.writerows(rows)

    flagged = [row for row in rows if row["issues"]]
    for row in flagged:
        print(f"{row['url']}  ->  {row['issues']}")
    print(f"checked {len(rows)} pages, {len(flagged)} need attention")
    raise SystemExit(1 if flagged else 0)


if __name__ == "__main__":
    main()
脚本只检查您自己的网站,不采集搜索结果:搜索引擎把结果提供给真实浏览器,对自动化请求会很快弹出验证。排名请在浏览器中通过同一代理手动查看。把 ACCEPT_LANGUAGE 设置为受众的语言:否则根据浏览器选择语言的网站会把脚本引到其他版本。
SEO 需要哪个套餐
手动检查用低档套餐即可;代理公司需要高档套餐。
手动检查和页面审核
最高 5 Mbps 足以查看搜索结果和审核您的页面。这个套餐同样支持通过链接和定时器更换 IP。
- 每台设备 $4,30 天
- 速度最高 5 Mbps
- 通过链接和定时器更换 IP
- 登录验证或 IP 白名单访问
同时做多个项目的代理公司
当多人和多项服务通过同一部手机工作时,每一方都可以有单独的连接,并设置各自的流量和速度上限。手机较多时,批量折扣就能体现价值。
- 每台设备 $7,30 天
- 速度最高 100 Mbps
- 每个连接都可设置限额
- 设备批量折扣
如何避免检查结果失真
干净的配置文件
搜索历史和已登录的账号会影响排名。请在未登录搜索引擎账号、没有积累历史的配置文件中检查。
先确认地址
通过同一代理打开 Mobihub 网站上的 IP 检测页面,确认地址属于所需的运营商和地区。
用于检查,而非操纵
移动代理用于查看搜索结果和您的网站。伪造点击、操纵行为信号违反搜索引擎规则,网站可能因此受到处罚。
相同的条件
对比运营商时,使用相同的 User-Agent,并在同一时间检查。否则报告的差异可能来自浏览器或搜索结果更新。
会话中途不要更换 IP
检查过程中更换地址会重置地区,还可能触发验证码。请设置较长的自动更换间隔,或在会话之间通过链接更换 IP。
