بروكسي موبايل لتحسين محركات البحث (SEO)
تعتمد نتائج البحث على الجوال على المنطقة والجهاز، وقد يستجيب الموقع لمشتركي المشغّلين المختلفين بطرق مختلفة. عبر بروكسي موبايل على شريحة SIM الخاصة بك ترى النتائج وموقعك كما يراهما مستخدم هاتف ذكي في منطقتك. ويفحص السكربت أدناه ما يحصل عليه زوار الجوال على صفحاتك.
- المنطقة
- حيثما يعمل الهاتف
- HTTP + SOCKS5
- للمتصفح والسكربتات
- من 3 دقائق
- فاصل تغيير IP التلقائي
- 24 ساعة
- وصول مجاني للعملاء الجدد
لماذا يحتاج متخصص السيو إلى عنوان موبايل
تراعي محركات البحث منطقة المستخدم، ونتائج الجوال تختلف عن نتائج الكمبيوتر. الفحص من IP المكتب يُظهر الترتيب للمكتب، بينما يهتم العميل بما يراه مشترٍ يحمل هاتفًا في مدينته.
وقد يستجيب الموقع أيضًا بشكل مختلف. أحيانًا تقطع الحماية من الروبوتات شبكات المشغّلين الفرعية، ويقدّم CDN نسخة قديمة في منطقة ما، ويرسل التوجيه الجغرافي زوار الجوال إلى النسخة الخاطئة. لا شيء من هذا يظهر من كمبيوتر المكتب.
في Mobihub يعمل البروكسي على هاتفك بشريحة SIM من المشغّل الذي تحتاجه. والمتصفح خلف بروكسي كهذا يرى نتائج البحث والموقع بعين مشترك موبايل لدى ذلك المشغّل.
مشغّلان لمدة شهر
تفتح الأداة على باقة Beginner بجهازين. تكفي سرعة حتى 5 Mbps للفحص اليدوي للنتائج وتدقيق صفحاتك، ويُظهر هاتفان بشريحتين من مشغّلين مختلفين كيف تختلف الشبكات. إذا كنت تغطي مناطق أكثر، فأضف هاتفًا لكل منها.
كيف تفحص نتائج البحث وموقعك عبر بروكسي موبايل
النظرة اليدوية إلى النتائج والتدقيق الآلي لصفحاتك يكمّل أحدهما الآخر.
اربط هاتفًا في المنطقة المطلوبة
ثبّت Mobihub على هاتف Android بشريحة SIM من مشغّل شائع لدى جمهورك، وأنشئ عليه بروكسي.
جهّز ملف تعريف متصفح منفصلًا
ضع البروكسي في ملف تعريف متصفح منفصل أو في متصفح antidetect، حتى لا يؤثر سجل متصفح العمل وملفات cookies فيه على النتائج.
افحص النتائج يدويًا
حوّل المتصفح إلى وضع الجوال وقارن الترتيب والمقتطفات بتقرير أداة تتبع الترتيب. توقف محركات البحث الجمع الآلي للنتائج سريعًا باختبار تحقق، لذا لا نكتب له سكربتًا.
شغّل تدقيقًا لصفحاتك
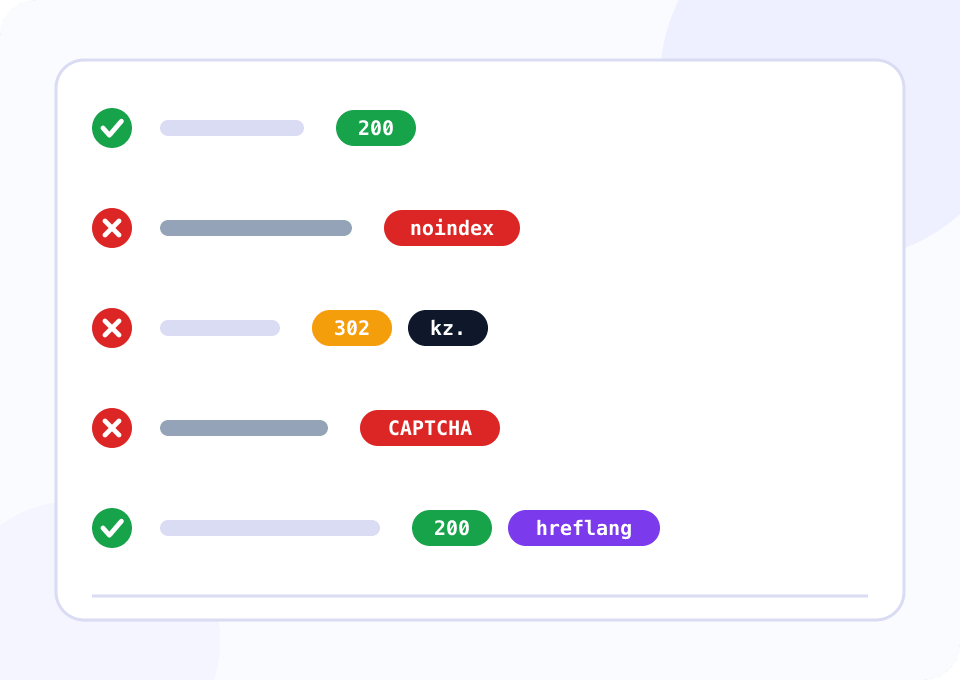
يمر السكربت أدناه على صفحاتك عبر البروكسي ويُظهر ما يحصل عليه زائر الجوال: رمز الحالة والعنوان النهائي وcanonical وhreflang وnoindex.
قارن بين المشغّلين
شغّل السكربت عبر هواتف على مشغّلين مختلفين وقارن التقارير. تشير الفروق في رموز الحالة والعناوين النهائية إلى الحماية من الروبوتات أو CDN أو التوجيه الجغرافي.
سكربت: ما يحصل عليه زائر الجوال على صفحاتك
يأخذ السكربت الروابط من pages.txt، ويفتح كلًا منها عبر بروكسي الموبايل بـ User-Agent لهاتف ذكي، ويسجل رمز الحالة والعنوان النهائي وtitle وcanonical وhreflang وnoindex من meta robots وترويسة X-Robots-Tag. يضع علامة على صفحة «تحقق من أنك إنسان»، وعلى التوجيه إلى مضيف آخر، وcanonical أجنبي، وصفحة دون viewport، ثم يطبع هذه الصفحات وينتهي بالرمز 1.
import csv
import re
from html.parser import HTMLParser
from urllib.parse import urljoin, urlparse

import requests

PROXY = "http://LOGIN:PASSWORD@HOST:PORT"
PAGES_FILE = "pages.txt"
REPORT_FILE = "seo_mobile_report.csv"
ACCEPT_LANGUAGE = "ru-RU,ru;q=0.9"
BLOCK_PHRASES = ("verify you are human", "are you a robot", "unusual traffic", "access denied", "не робот")
HEADERS = {
    "User-Agent": "Mozilla/5.0 (Linux; Android 14; Pixel 8) AppleWebKit/537.36 "
    "(KHTML, like Gecko) Chrome/126.0 Mobile Safari/537.36",
    "Accept-Language": ACCEPT_LANGUAGE,
}

proxies = {"http": PROXY, "https": PROXY}


class HeadParser(HTMLParser):
    def __init__(self):
        super().__init__()
        self.title = ""
        self.canonical = ""
        self.robots = ""
        self.hreflang = []
        self.viewport = False
        self.in_title = False

    def handle_starttag(self, tag, attrs):
        attrs = {key.lower(): value or "" for key, value in attrs}
        if tag == "title":
            self.in_title = True
        elif tag == "link":
            rel = attrs.get("rel", "").lower().split()
            if "canonical" in rel:
                self.canonical = attrs.get("href", "")
            if "alternate" in rel and attrs.get("hreflang"):
                self.hreflang.append(attrs["hreflang"])
        elif tag == "meta":
            name = attrs.get("name", "").lower()
            if name in ("robots", "googlebot", "yandex"):
                self.robots += " " + attrs.get("content", "").lower()
            if name == "viewport":
                self.viewport = True

    def handle_endtag(self, tag):
        if tag == "title":
            self.in_title = False

    def handle_data(self, data):
        if self.in_title:
            self.title += data


def visible_text(html):
    html = re.sub(r"(?is)<(script|style)\b.*?</\1>", " ", html[:20000])
    return re.sub(r"<[^>]+>", " ", html).lower()


def host(url):
    name = urlparse(url).hostname or ""
    return name[4:] if name.startswith("www.") else name


def audit(url):
    row = {"url": url, "status": "", "final_url": "", "title": "", "canonical": "", "hreflang": "", "robots": "", "issues": ""}
    try:
        response = requests.get(url, headers=HEADERS, proxies=proxies, timeout=30)
    except requests.RequestException as error:
        row.update(status="error", issues=type(error).__name__)
        return row

    page = HeadParser()
    page.feed(response.text)
    robots = (page.robots + " " + response.headers.get("X-Robots-Tag", "").lower()).strip()
    canonical = urljoin(response.url, page.canonical) if page.canonical else ""
    issues = []
    if response.status_code != 200:
        issues.append(f"status {response.status_code}")
    if any(phrase in visible_text(response.text) for phrase in BLOCK_PHRASES):
        issues.append("captcha or block page for this carrier")
    if host(response.url) != host(url):
        issues.append("redirected to another host")
    if "noindex" in robots:
        issues.append("noindex")
    if not canonical:
        issues.append("no canonical")
    elif host(canonical) != host(response.url):
        issues.append("canonical points to another host")
    if not page.viewport:
        issues.append("no viewport meta")

    row.update(
        status=response.status_code,
        final_url=response.url,
        title=" ".join(page.title.split())[:80],
        canonical=canonical,
        hreflang=",".join(page.hreflang),
        robots=robots,
        issues="; ".join(issues),
    )
    return row


def main():
    with open(PAGES_FILE) as f:
        urls = [line.strip() for line in f if line.strip()]

    if not urls:
        raise SystemExit(f"{PAGES_FILE} is empty")
    rows = [audit(url) for url in urls]
    with open(REPORT_FILE, "w", newline="") as f:
        writer = csv.DictWriter(f, fieldnames=list(rows[0].keys()))
        writer.writeheader()
        writer.writerows(rows)

    flagged = [row for row in rows if row["issues"]]
    for row in flagged:
        print(f"{row['url']}  ->  {row['issues']}")
    print(f"checked {len(rows)} pages, {len(flagged)} need attention")
    raise SystemExit(1 if flagged else 0)


if __name__ == "__main__":
    main()
يفحص السكربت موقعك فقط ولا يجمع نتائج البحث: تقدّمها محركات البحث لمتصفح حقيقي وتعرض سريعًا اختبار تحقق للطلبات الآلية. انظر إلى الترتيب يدويًا في متصفح عبر البروكسي نفسه. اضبط ACCEPT_LANGUAGE على لغة جمهورك: وإلا فإن المواقع التي تختار اللغة من المتصفح سترسل السكربت إلى نسخة أخرى.
أي باقة يحتاجها السيو
الفحص اليدوي تناسبه الباقة الأدنى؛ أما الوكالة فتحتاج إلى الأعلى.
الفحص اليدوي والتدقيق
تكفي سرعة حتى 5 Mbps للنظر في نتائج البحث وتدقيق صفحاتك. وتغيير IP برابط وبمؤقت متاح على هذه الباقة أيضًا.
- $4 للجهاز لمدة 30 يومًا
- سرعة حتى 5 Mbps
- تغيير IP برابط وبمؤقت
- الوصول باسم المستخدم أو بقائمة عناوين IP مسموح بها
وكالة لديها عدة مشاريع
عندما يعمل عدة أشخاص وخدمات عبر هاتف واحد، يمكن أن يحصل كل منهم على اتصال منفصل بحد خاص للترافيك والسرعة. ويؤتي خصم الكمية ثماره مع عدة هواتف.
- $7 للجهاز لمدة 30 يومًا
- سرعة حتى 100 Mbps
- حدود لكل اتصال
- خصم الكمية على الأجهزة
كيف لا تشوّه الفحص
ملف تعريف نظيف
سجل البحث والحساب المسجّل يغيّران الترتيب. افحص في ملف تعريف دون حساب محرك بحث ودون سجل متراكم.
تحقق من العنوان أولًا
افتح صفحة فحص IP على موقع Mobihub عبر البروكسي نفسه، وتأكد من أن العنوان يتبع المشغّل والمنطقة المطلوبين.
فحص لا تلاعب
بروكسي الموبايل مخصص للنظر في النتائج وفي موقعك. تزييف النقرات والتلاعب بالإشارات السلوكية يخالف قواعد محركات البحث ويعرّض الموقع للعقوبات.
الظروف نفسها
قارن بين المشغّلين بـ User-Agent نفسه وفي الوقت نفسه. وإلا اختلفت التقارير بسبب المتصفح أو تحديث النتائج.
لا تغيير لعنوان IP أثناء الجلسة
تغيير العنوان أثناء الفحص يعيد ضبط المنطقة وقد يستدعي captcha. اضبط فاصلًا طويلًا للتغيير التلقائي أو غيّر IP برابط بين الجلسات.
أسئلة وأجوبة
هل ستطابق النتائج عبر البروكسي ما يراه عميلي؟
هل يمكن جمع الترتيب آليًا عبر بروكسيات الموبايل؟
لماذا أفحص موقعي من IP موبايل؟
هل أحتاج إلى هاتف منفصل لكل منطقة؟
أي User-Agent أستخدم لفحص نتائج الجوال؟
هل يؤثر تغيير IP في ترتيب موقعي؟
بروكسيات موبايل لمهام أخرى
شاهد النتائج بعين عميلك
يمنح الدعم الفني العملاء الجدد 24 ساعة من الوصول المجاني. اربط هاتفًا بشريحة SIM من المشغّل المطلوب، وقارن نتائج الجوال بتقرير أداة تتبع الترتيب.
